1時間の録音が、10秒で、15円
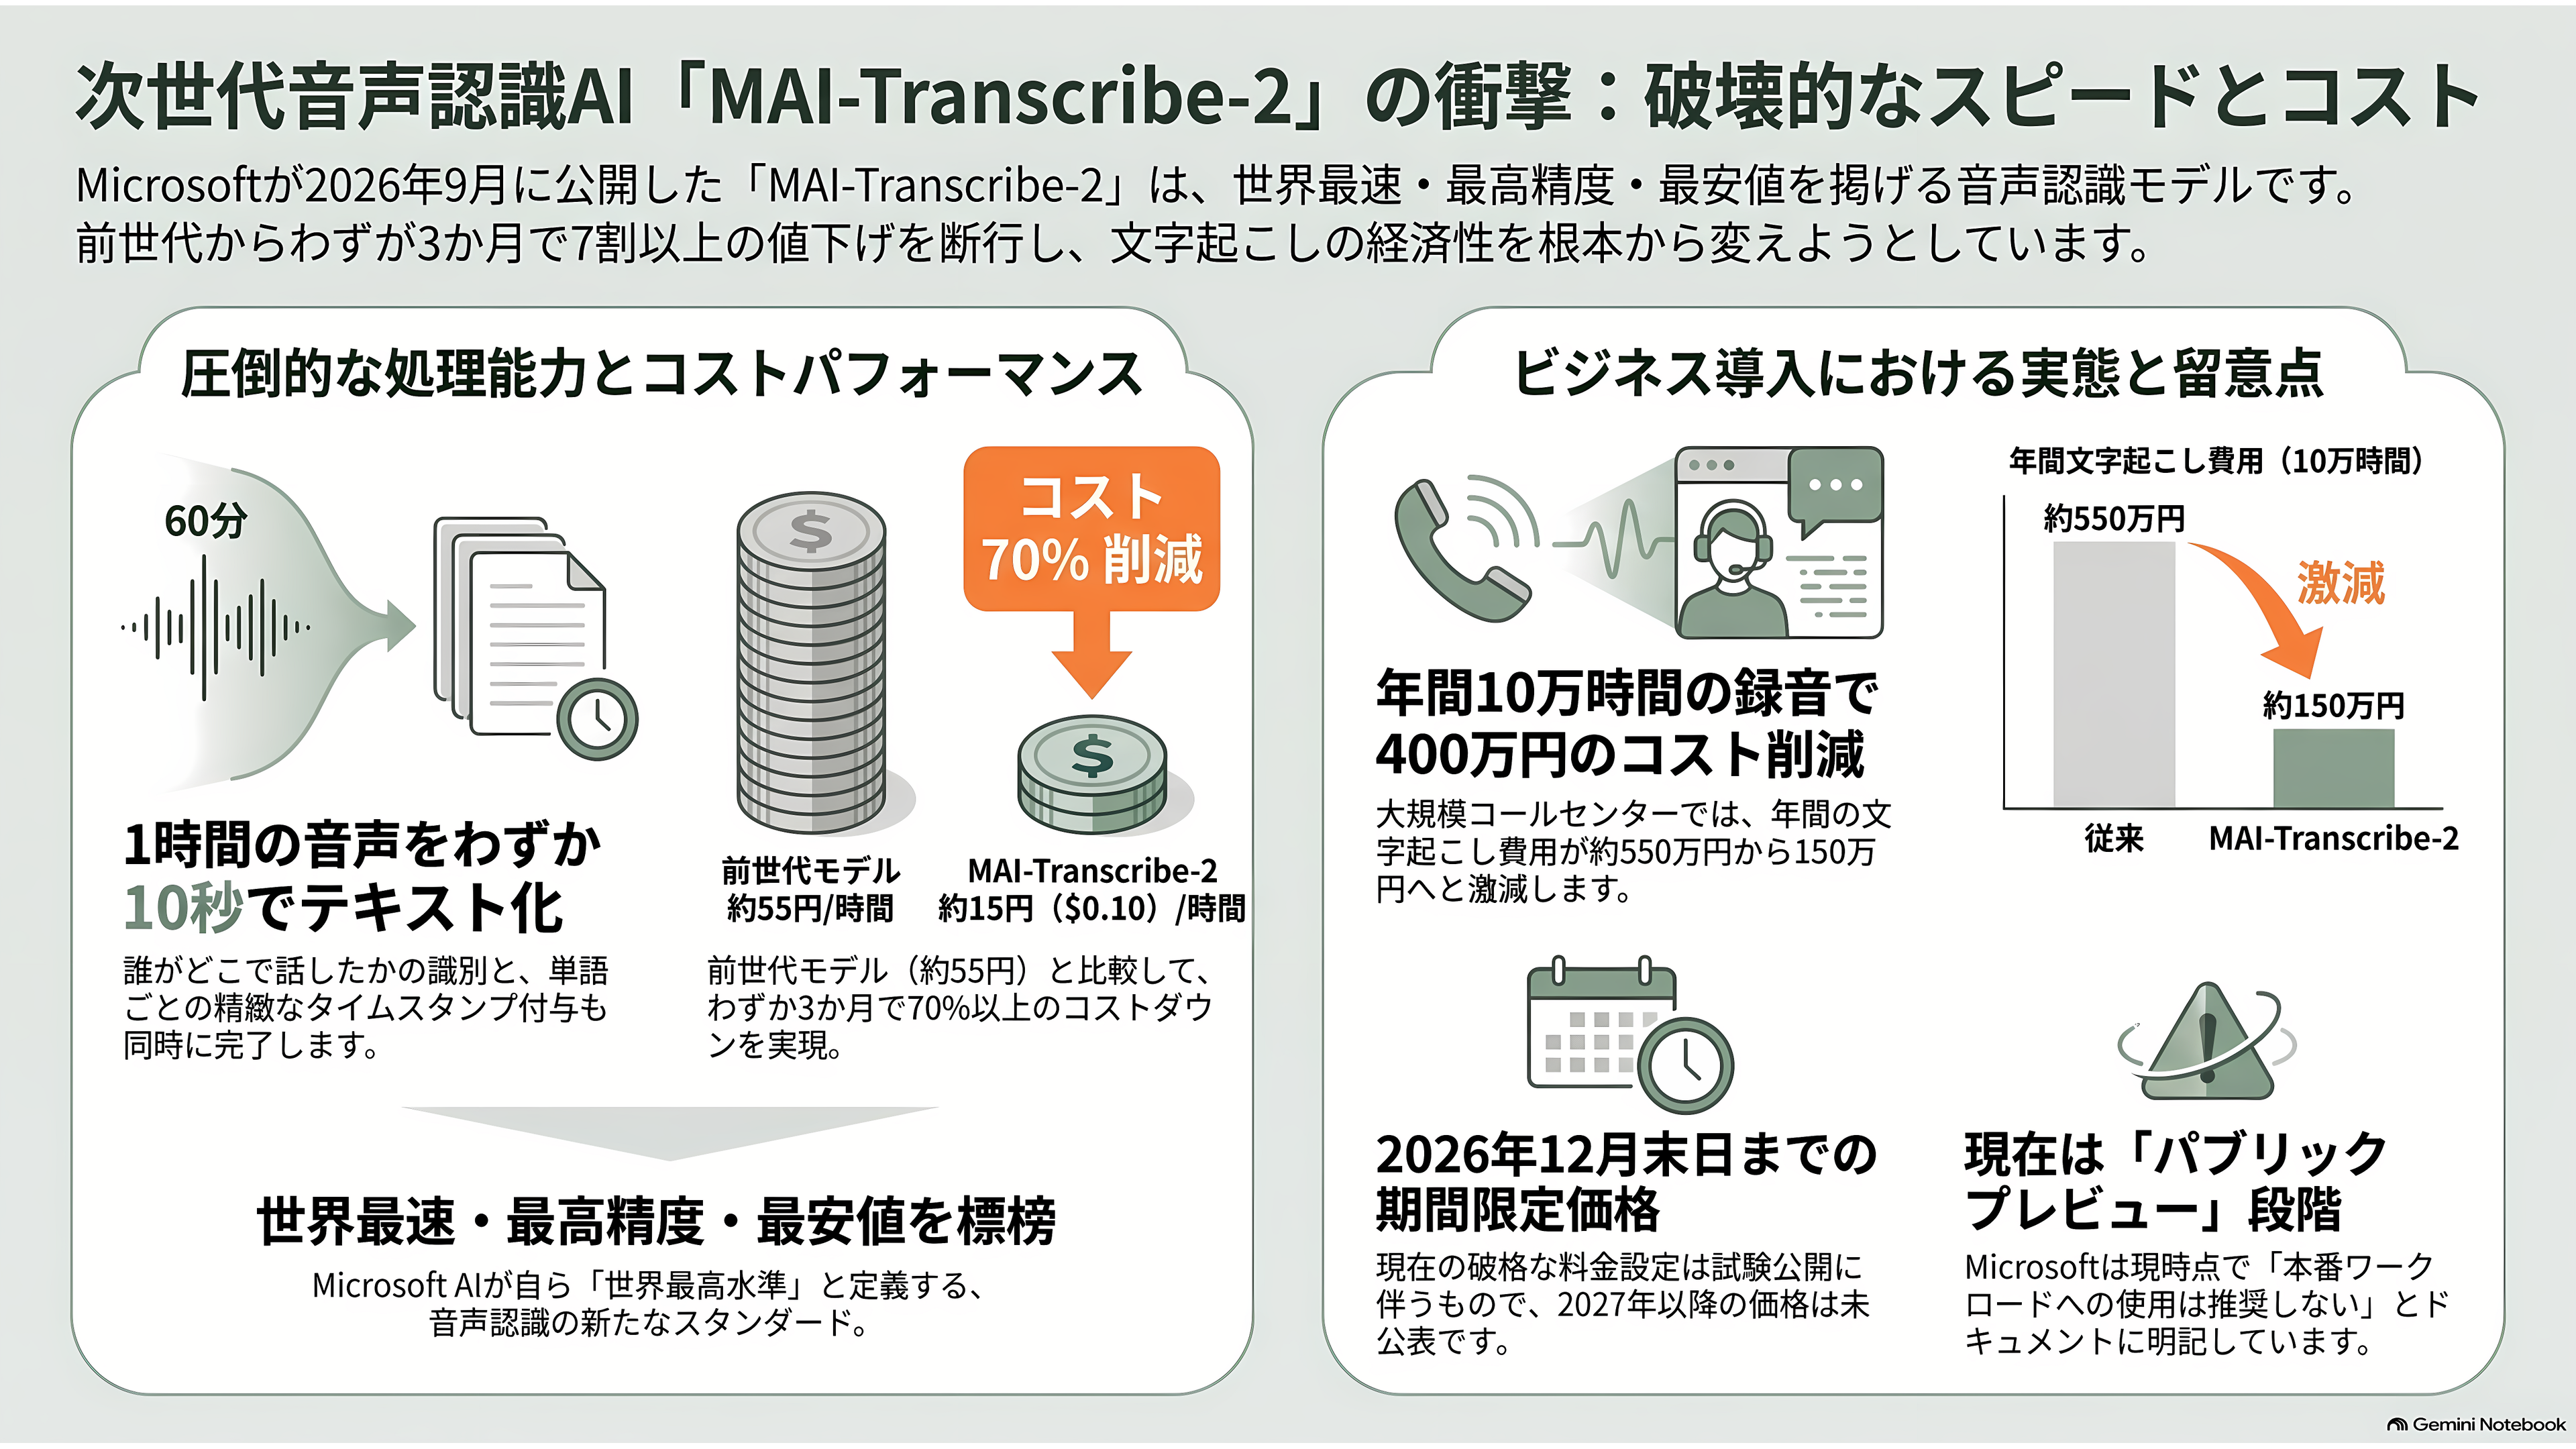
1時間ぶんの会議の録音を投げ込むと、10秒後には全文が返ってくる。誰がどこで喋ったかの区切りが付き、単語ひとつひとつに「何分何秒から何分何秒まで」の目印が入った状態で、である。かかる費用は、日本円にしておよそ15円だ。
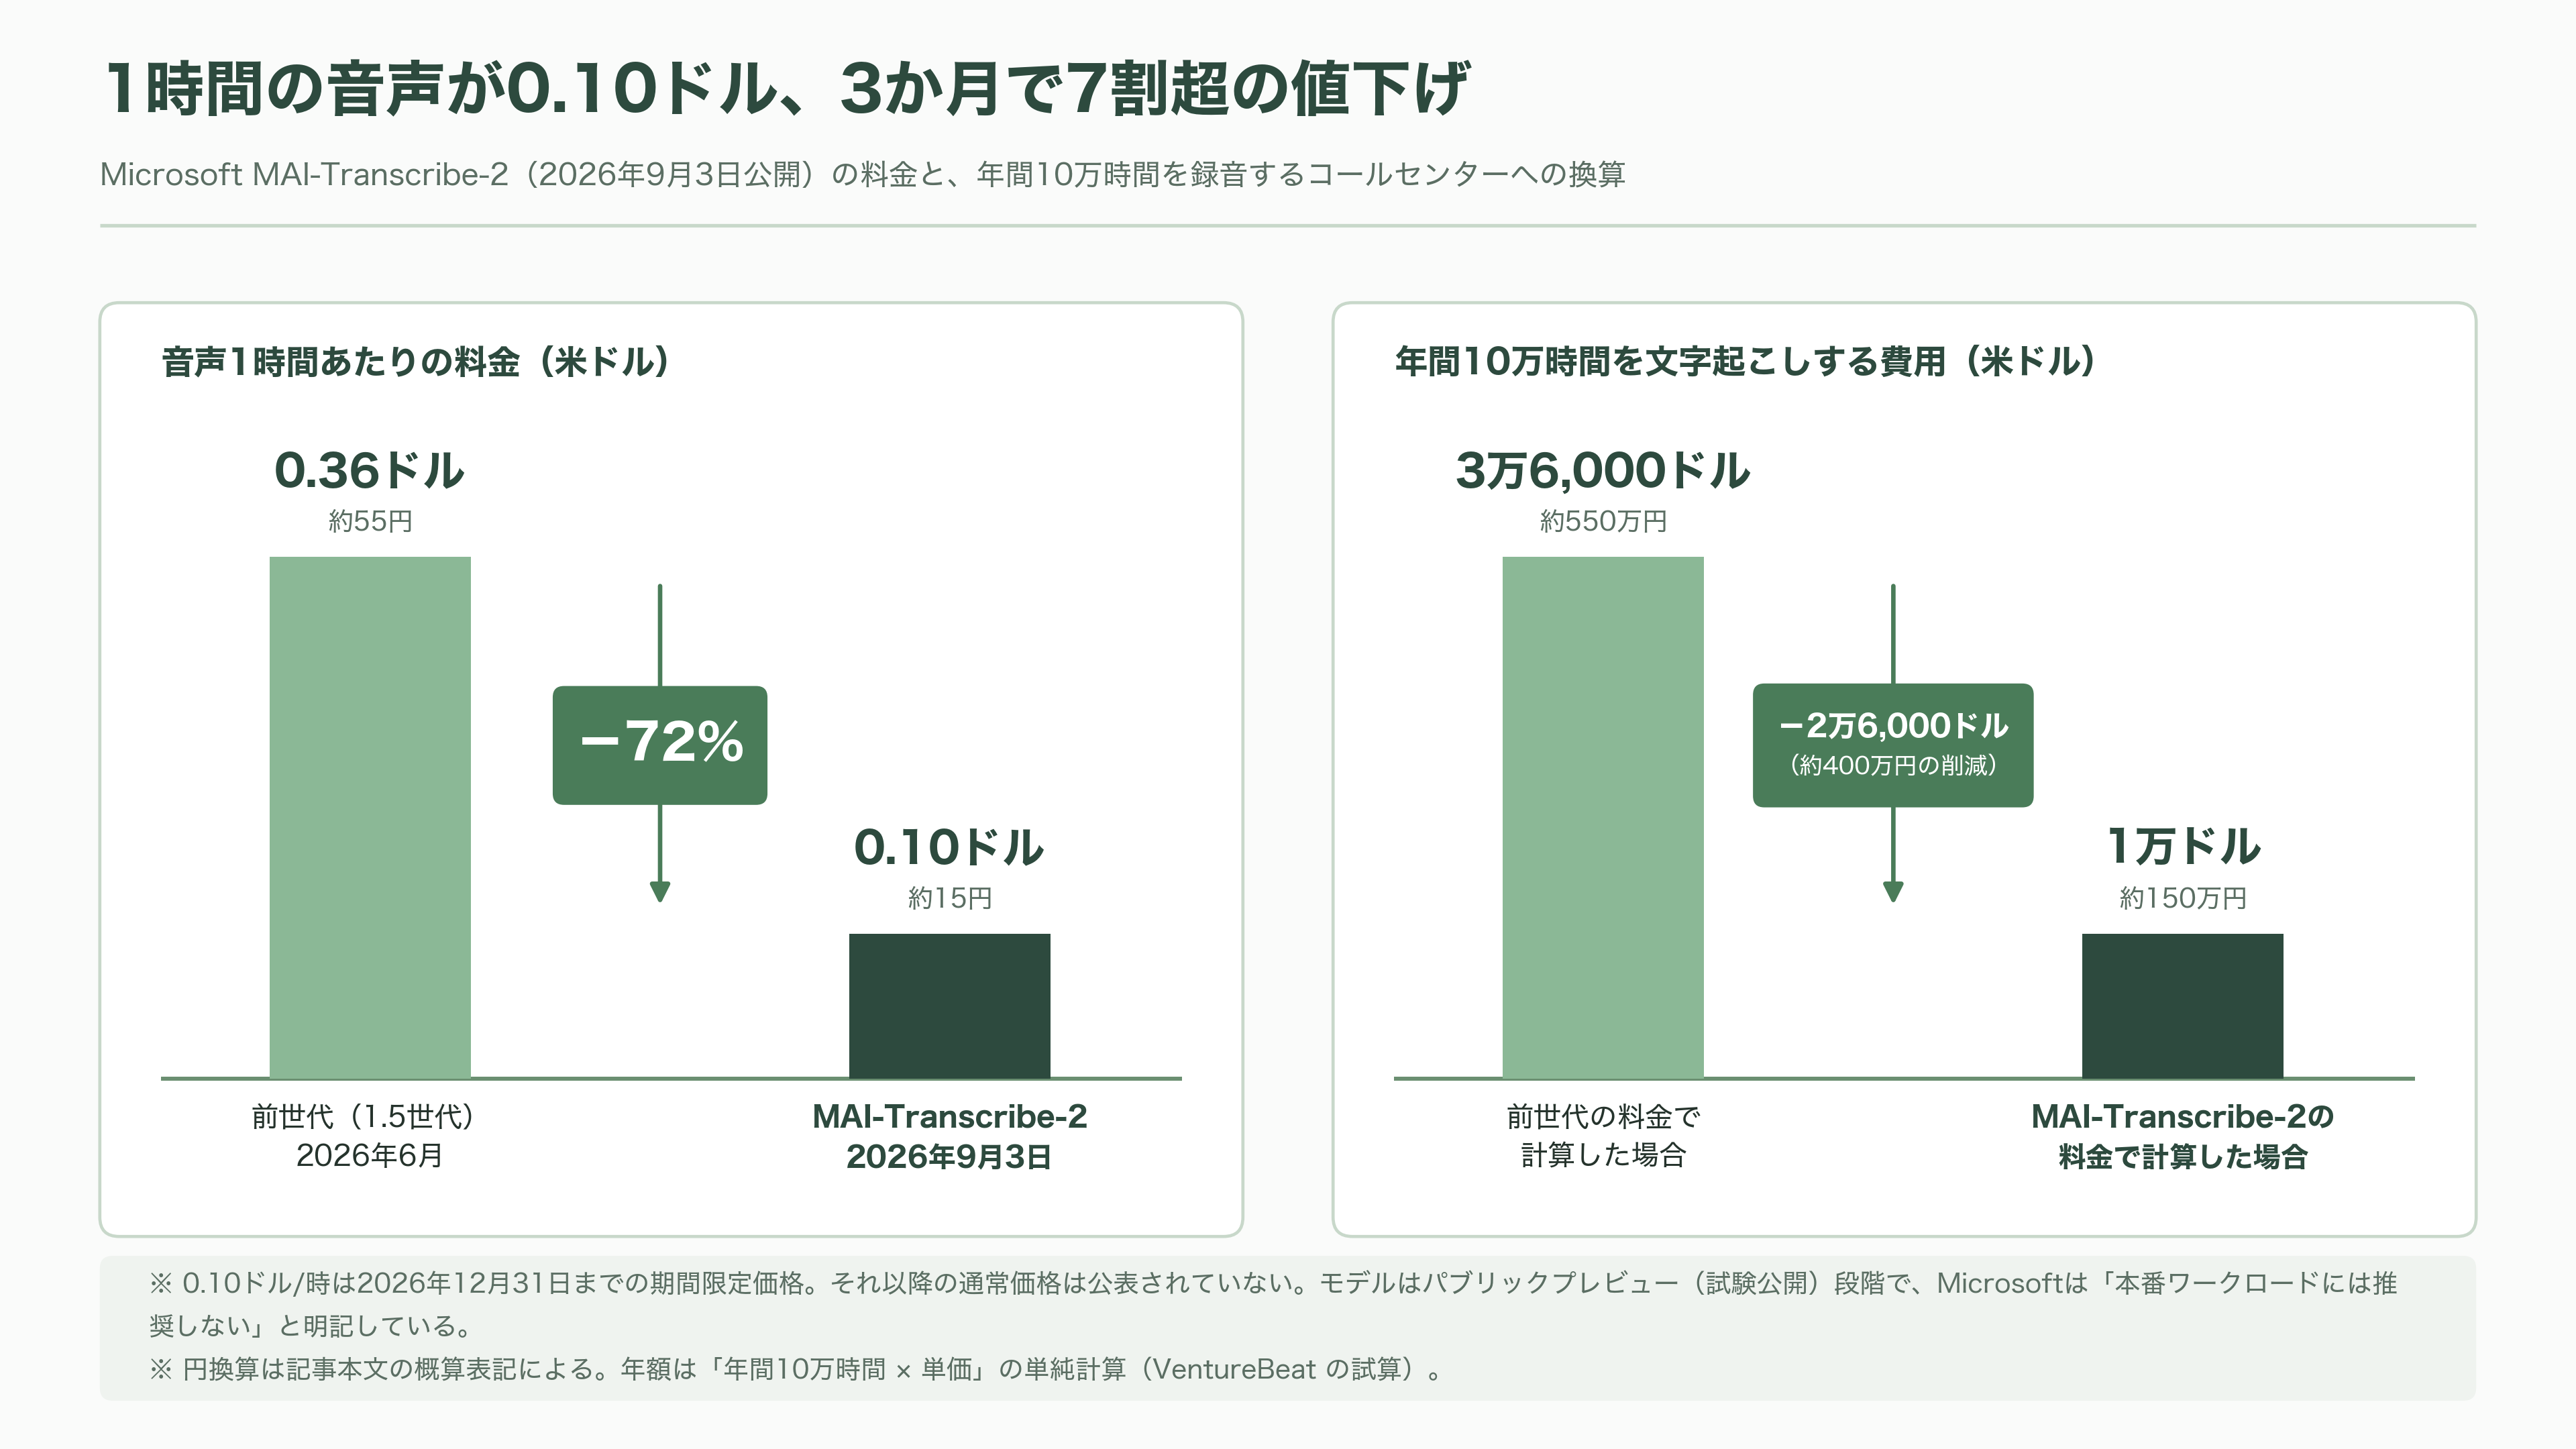
Microsoftが2026年9月3日に公開した音声認識モデル「MAI-Transcribe-2」の話である。料金は音声1時間あたり0.10ドル(約15円)。同社が6月に出した前の世代は1時間0.36ドル(約55円)だったので、3か月で7割以上の値下げということになる。
数字を業務の規模に置き換えると効き方が見えてくる。年間10万時間の通話を録音しているコールセンターがあったとして、旧価格なら文字起こしだけで年3万6,000ドル(約550万円)かかっていたものが、1万ドル(約150万円)で済む。VentureBeatはこの計算を挙げて、「130億ドル(約2兆円)を払って最先端AIの原価を学んだ企業が、成果物を借りるより工場を持つほうを選んだ」と書いた。
Microsoft AIは自社の発表を「世界でもっとも高速・高精度・低価格な音声認識モデル」と題した。ただしこの価格は2026年12月31日までの期間限定であり、その後いくらになるかは公表されていない。モデル自体もパブリックプレビュー、つまり試験公開の段階で、Microsoft自身がドキュメントに「本番ワークロードには推奨しない」と書いている。
音声認識モデルは、いま何をしているのか
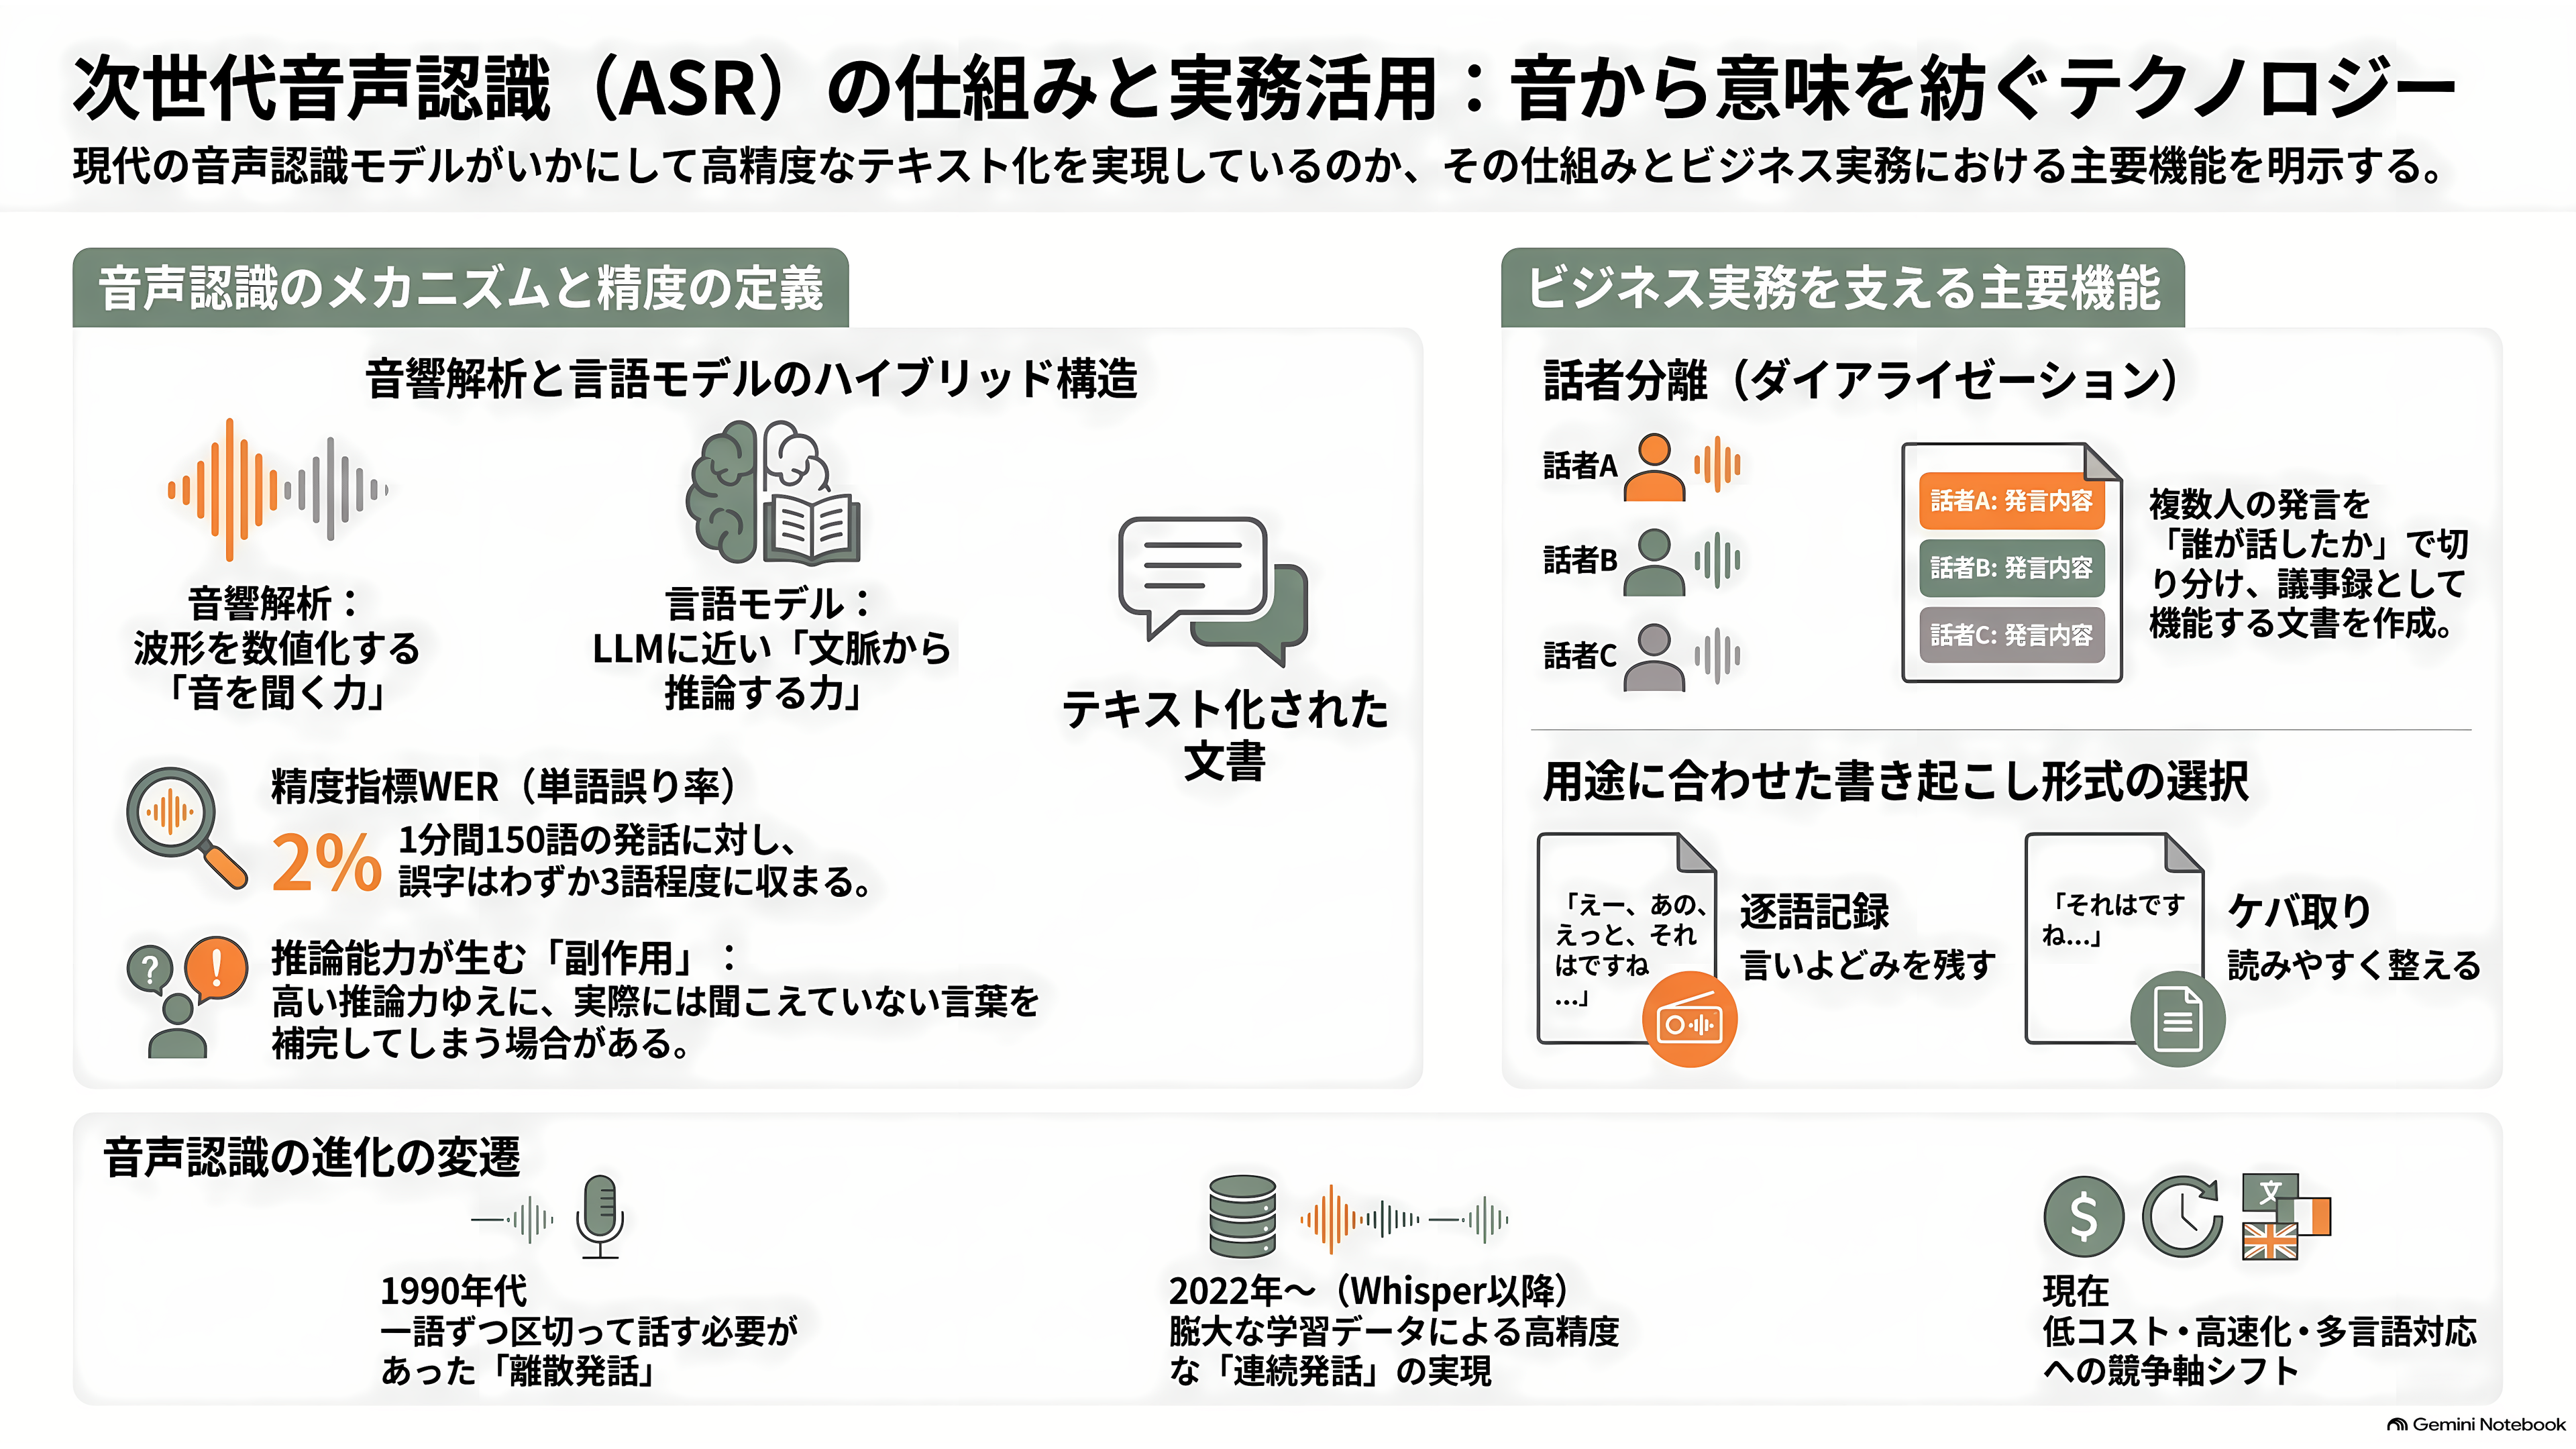
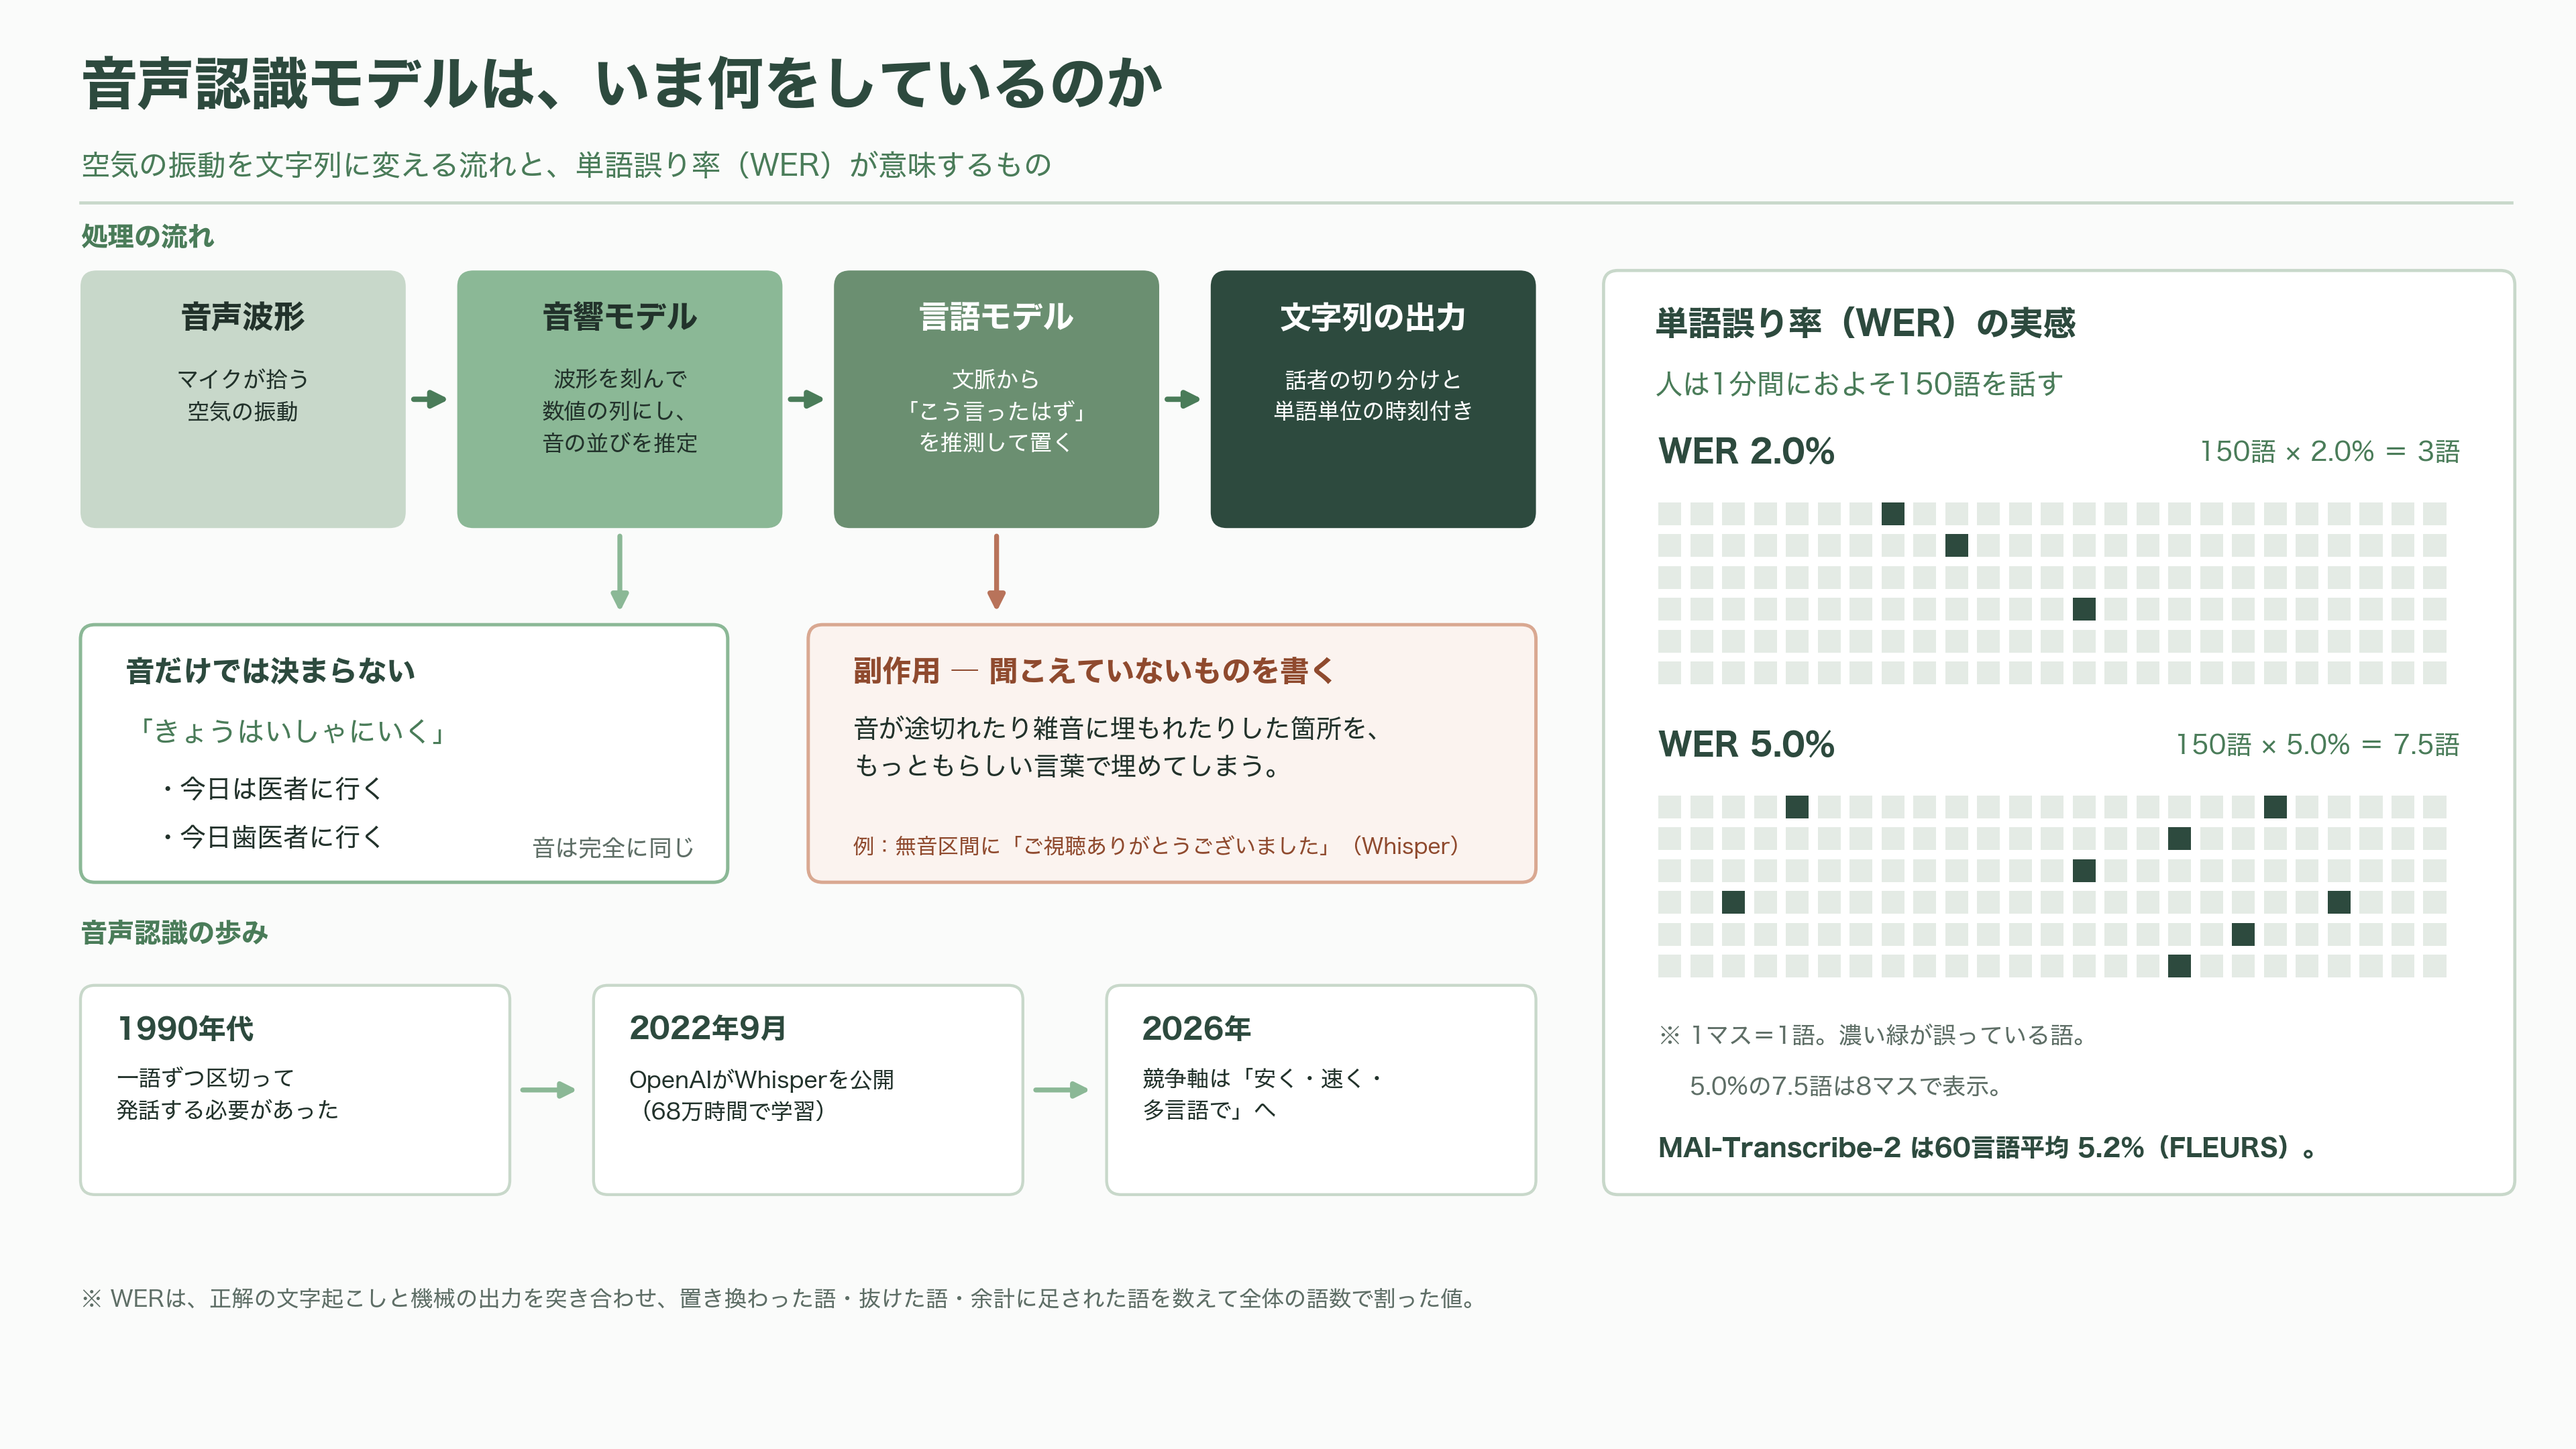
音声認識、英語で言うASR(Automatic Speech Recognition)がやっているのは、空気の振動を文字列に変える仕事だ。マイクが拾った波形を短い区切りに刻んで数値の列にし、その列から「どういう文字が並んでいたはずか」を推定する。
難しいのは、音だけでは決まらない部分が大量にあることだ。「きょうはいしゃにいく」という音の並びは、「今日は医者に行く」とも「今日歯医者に行く」とも書ける。音は完全に同じである。人間は文脈で瞬時に選ぶが、音だけを見ている機械にはこれができない。だから現代の音声認識モデルは、音を聞く部分と、言語の常識を持つ部分を組み合わせている。近年のモデルはこの後段に言語モデル、つまりLLMに近いものを積んでいて、「この流れならこう言ったはずだ」と推測しながら文字を置いていく。
この構造が精度を跳ね上げた一方で、後で触れる厄介な副作用も生んだ。推測が得意ということは、聞こえていないものを書く力も持っているということだからだ。
精度の指標には単語誤り率、WER(Word Error Rate)が使われる。正解の文字起こしと機械の出力を突き合わせて、置き換わった語・抜けた語・余計に足された語を数え、全体の語数で割る。人は1分間におよそ150語を話すので、WERが2%なら1分あたり3語、5%なら7語から8語がどこかで間違っている計算になる。
歴史の目盛りで言うと、1990年代の音声入力ソフトは一語ずつ区切って喋る必要があった。それが連続した話し言葉を扱えるようになり、2022年9月にOpenAIが68万時間の音声で学習したWhisperを公開して誰でも使える状態にしたことで、風景が一変した。以降の4年は、「どこまで精度を上げるか」から「どこまで安く、速く、たくさんの言語で回せるか」に競争軸が移っている。
もうひとつ、実務で効く機能が話者分離、いわゆるダイアライゼーションだ。5人が参加した会議の録音を文字にしても、誰の発言か分からない一本の川になっていては議事録にならない。「ここからここは話者A、次は話者B」と切り分けて初めて使える文書になる。MAI-Transcribe-2はこれを標準機能として持っている。
さらに、書き起こしの体裁も選べる。「えー」「あのー」といった言いよどみや言い直しを一字一句そのまま残すか、それらを削って読める文章に整えるか。APIのパラメータひとつで切り替わる。コンプライアンス記録として残すなら前者、字幕や公開議事録なら後者、という使い分けになる。
MAI-Transcribe-2の中身
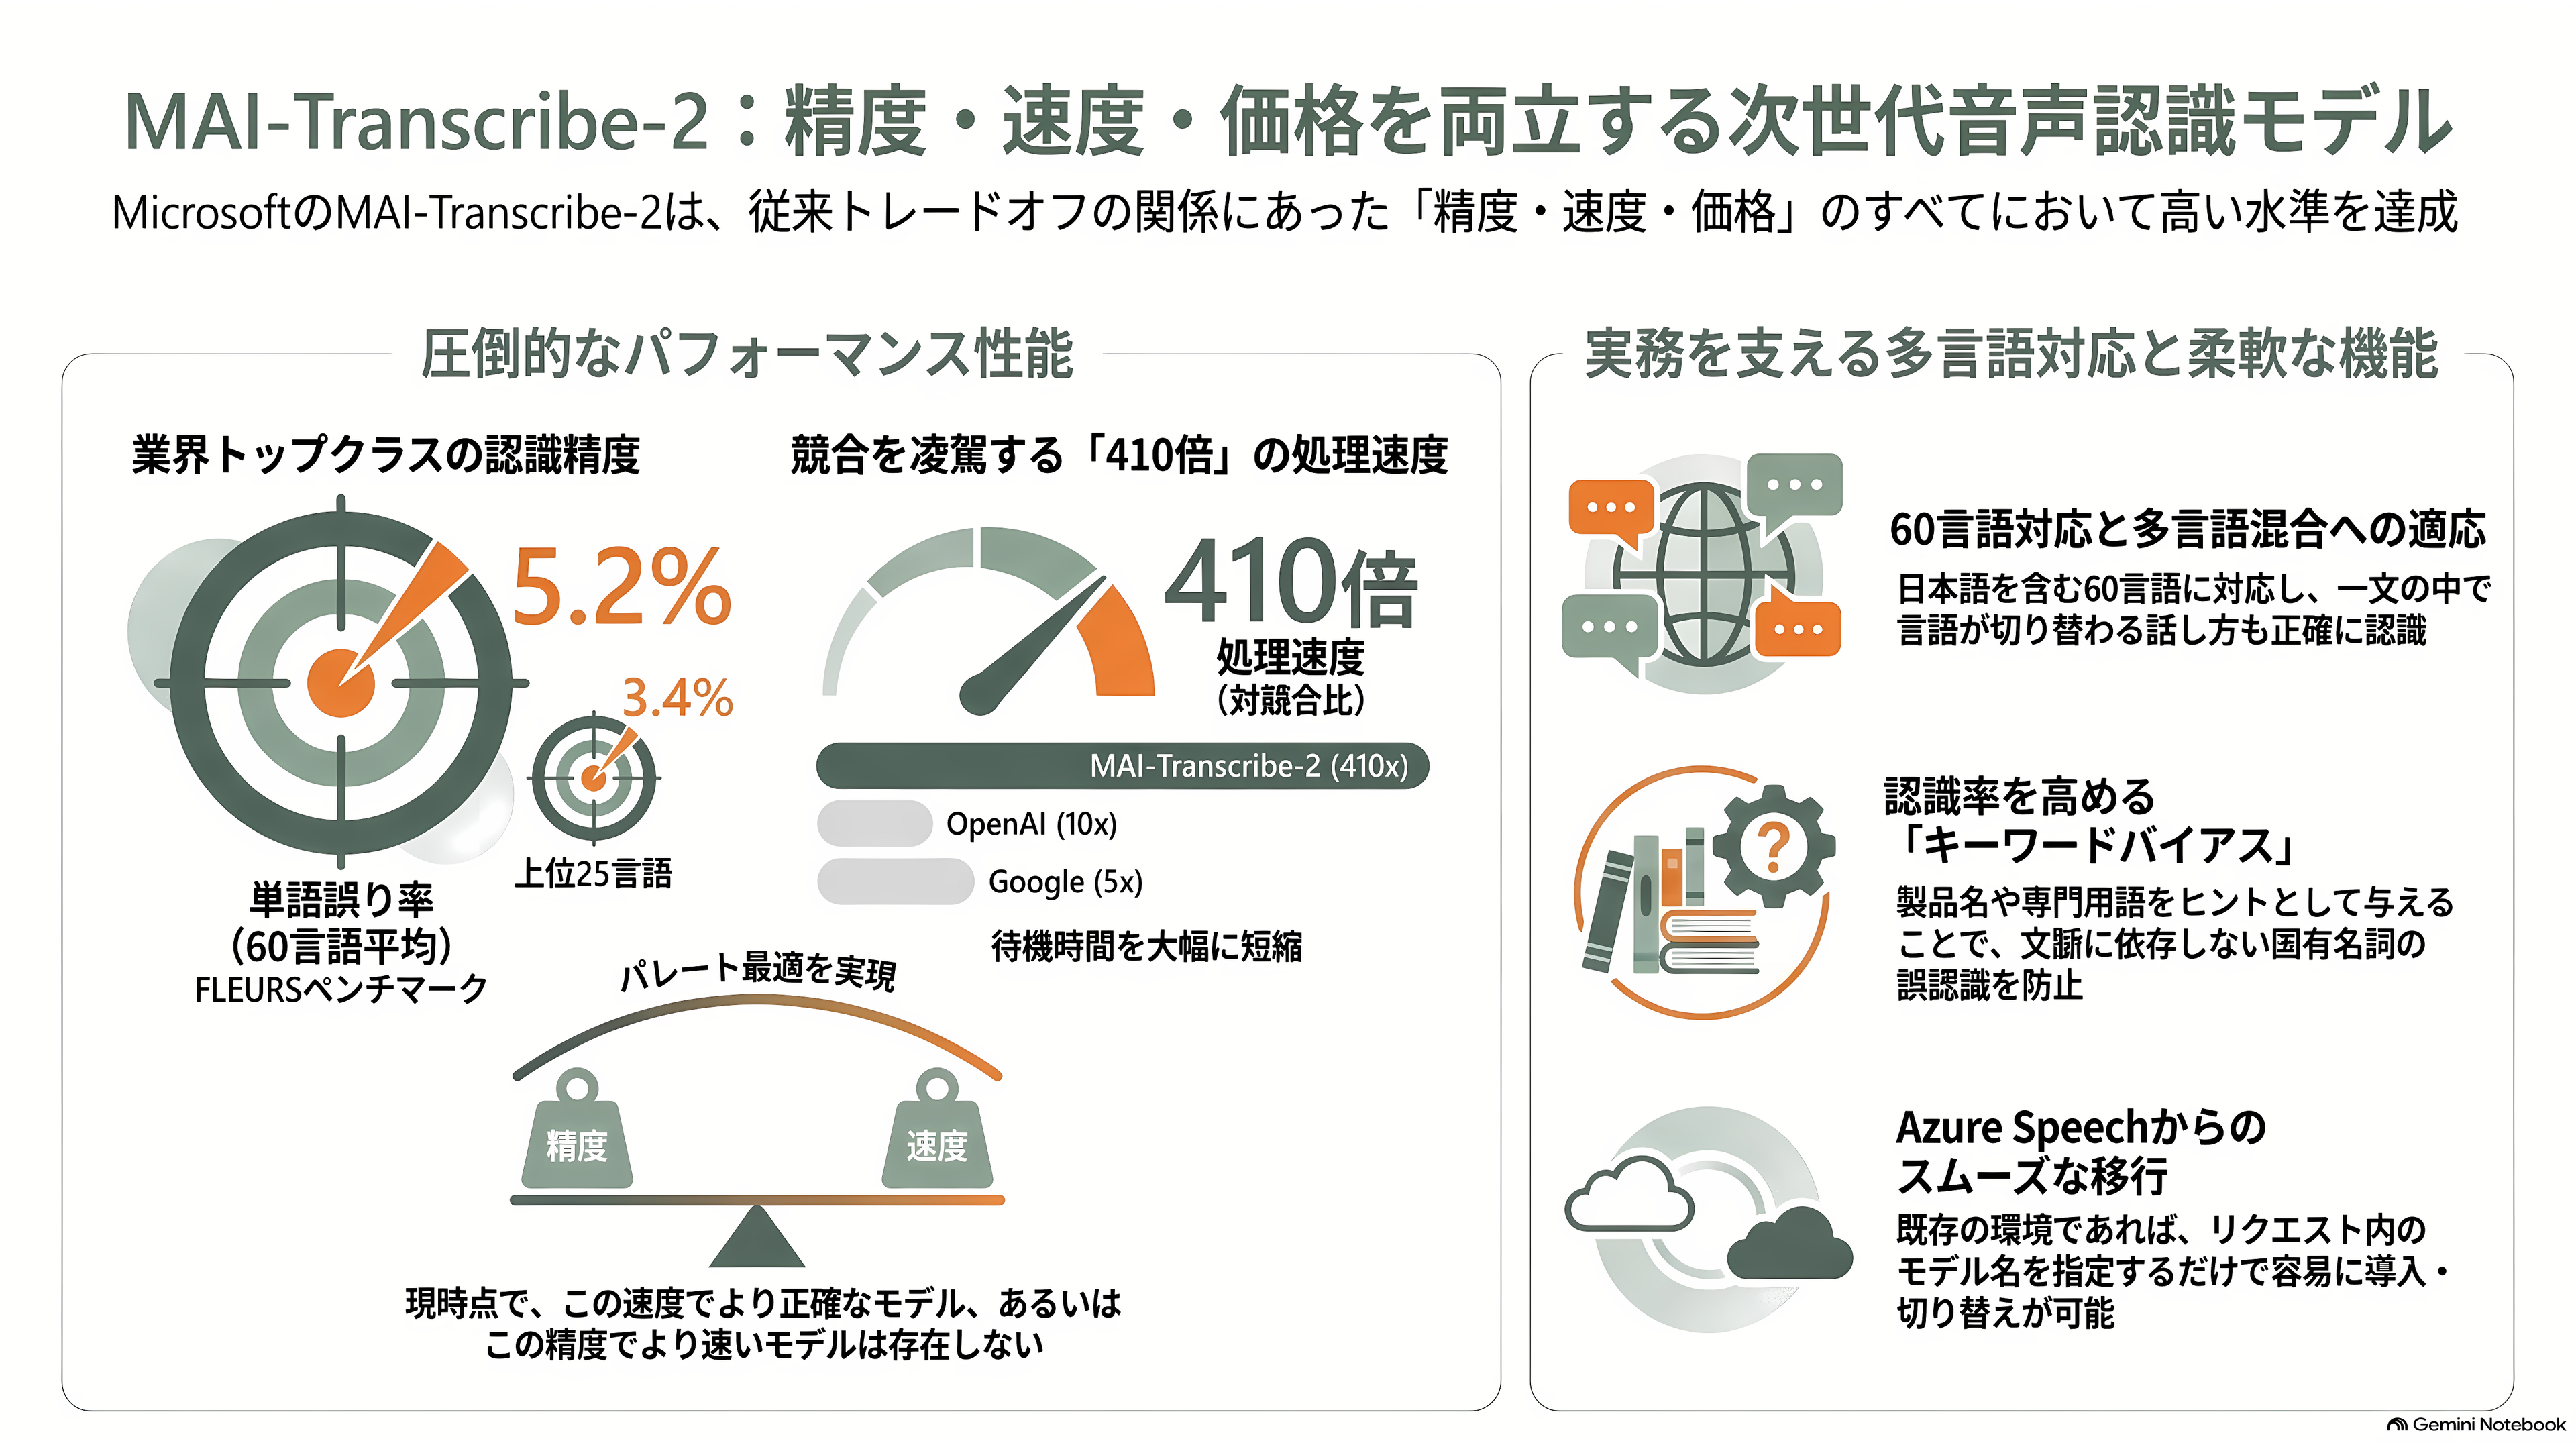
精度・速度・価格は、普通は同時に取れない。精度を上げれば大きなモデルが要り、大きなモデルは遅く高い。MAI-Transcribe-2の売り文句は、この三つを同時に取りにいったという点にある。
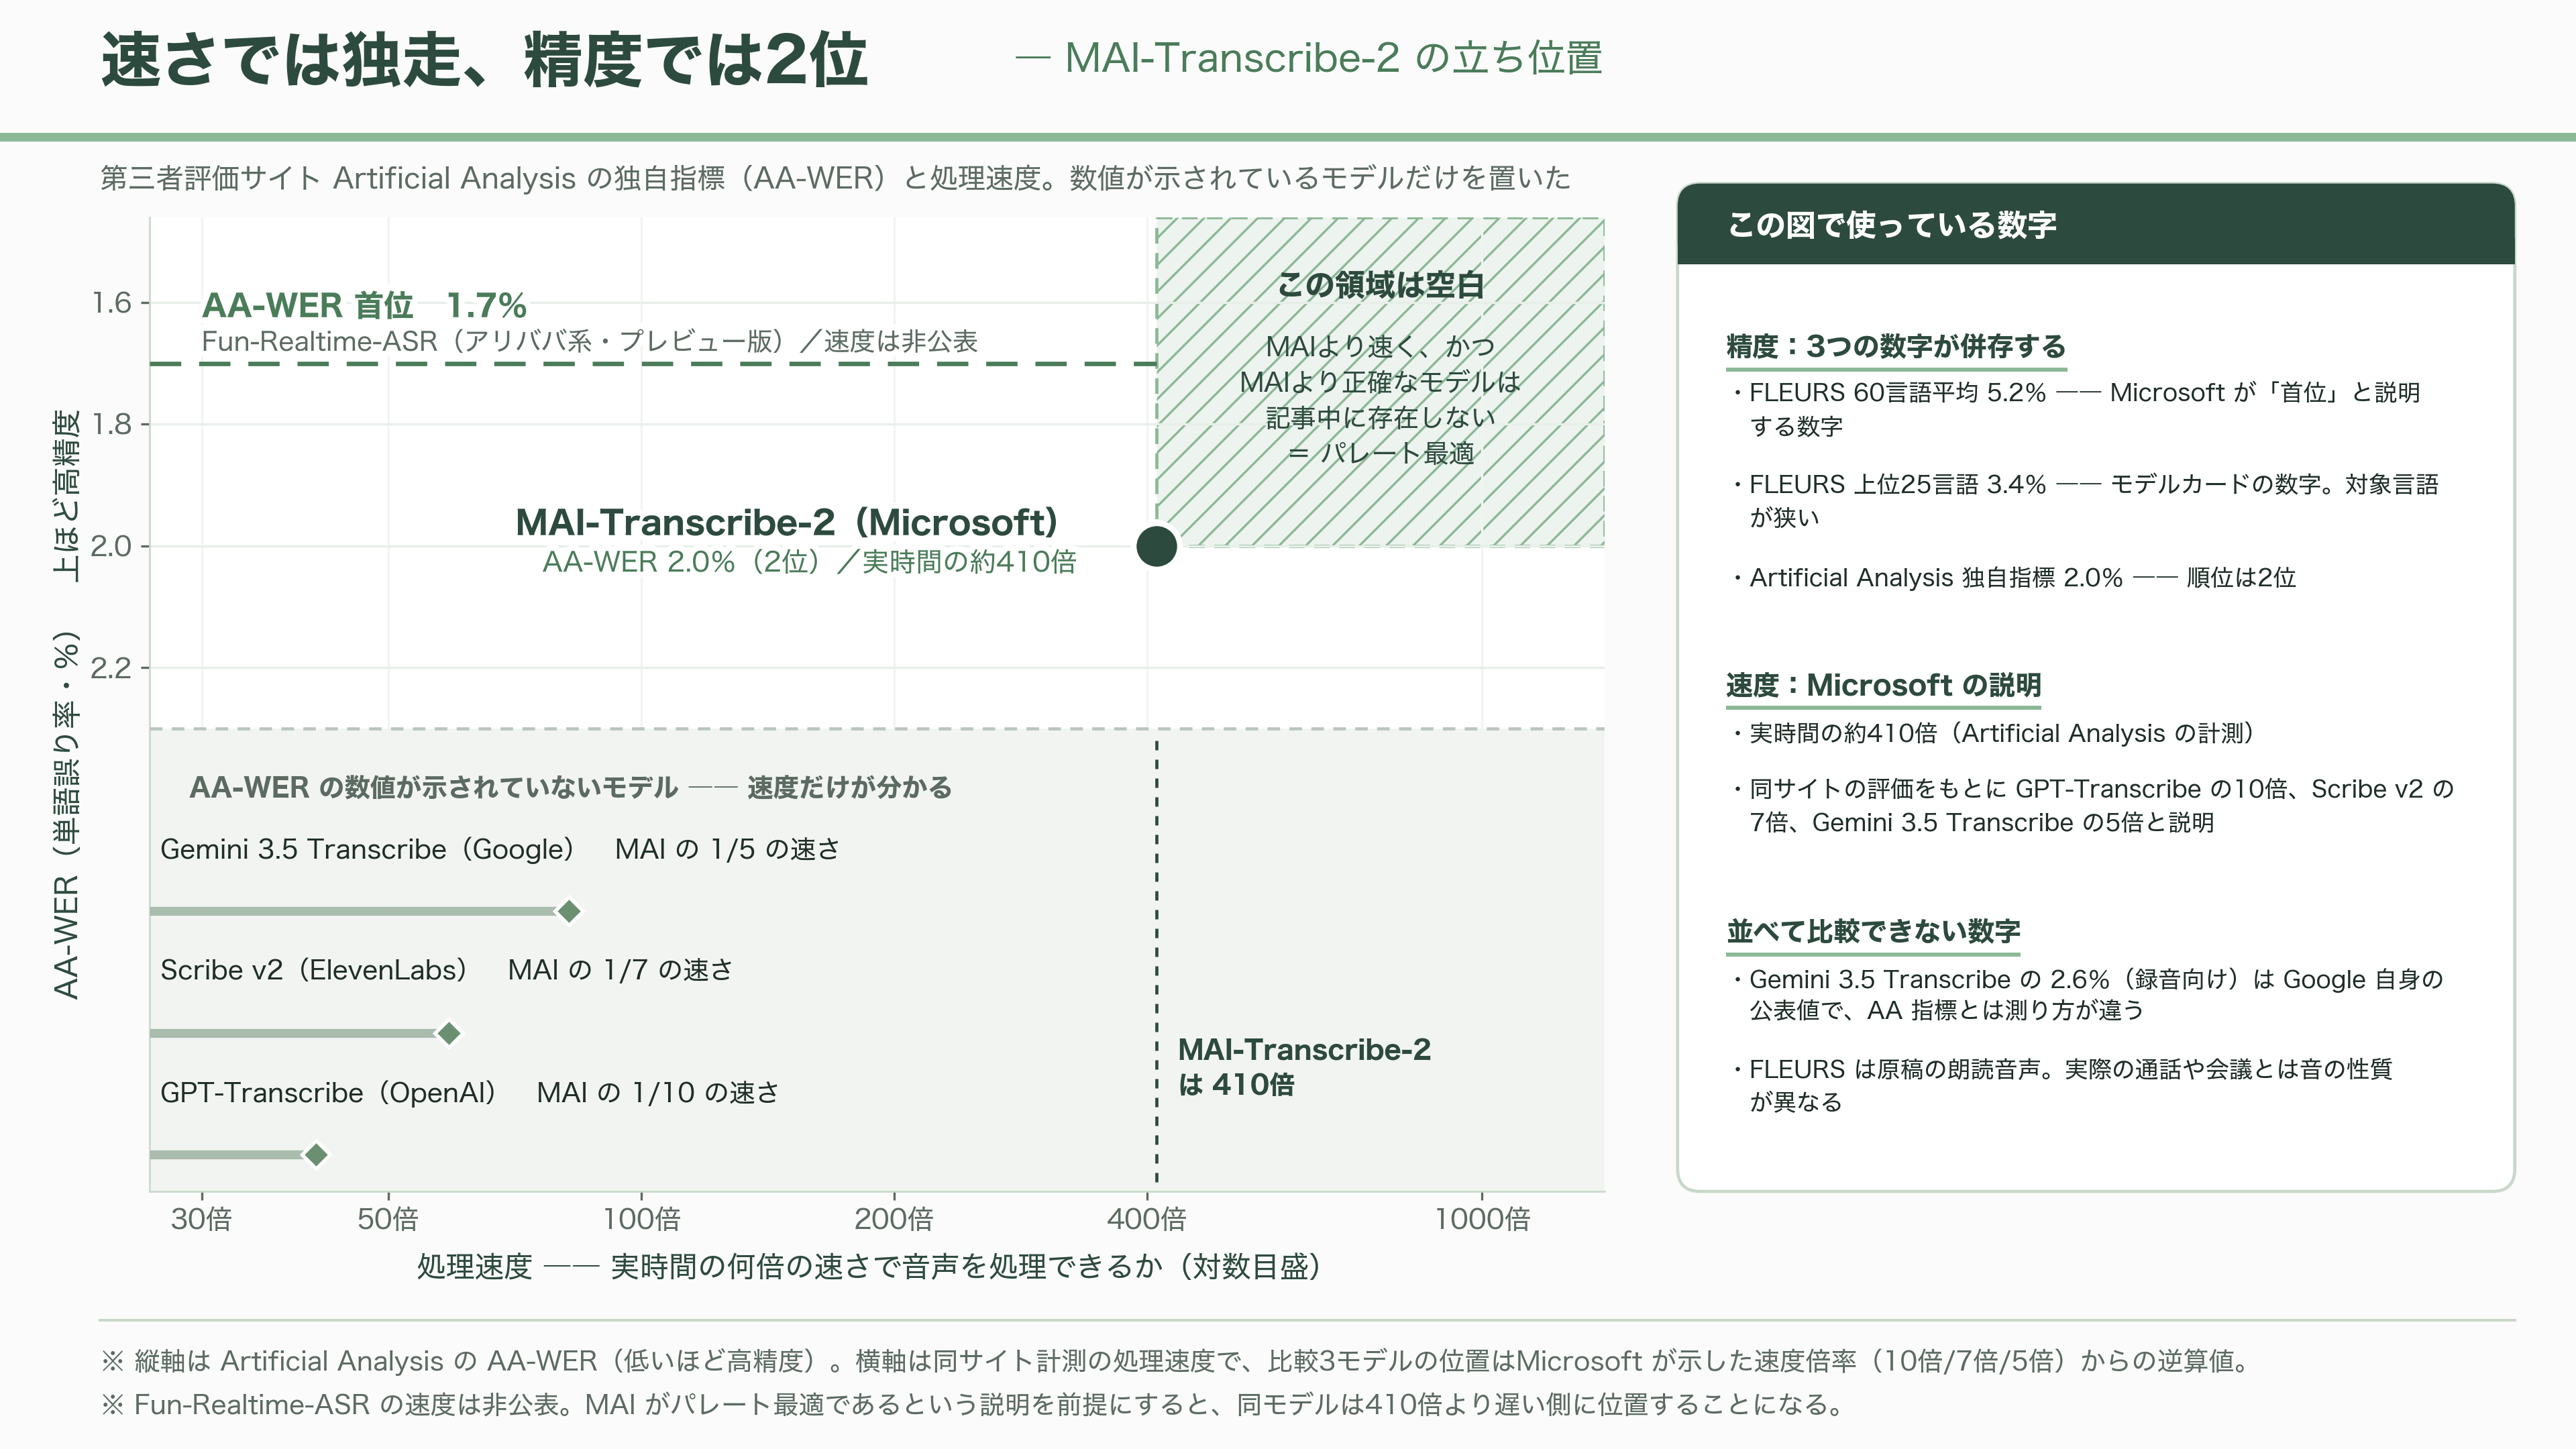
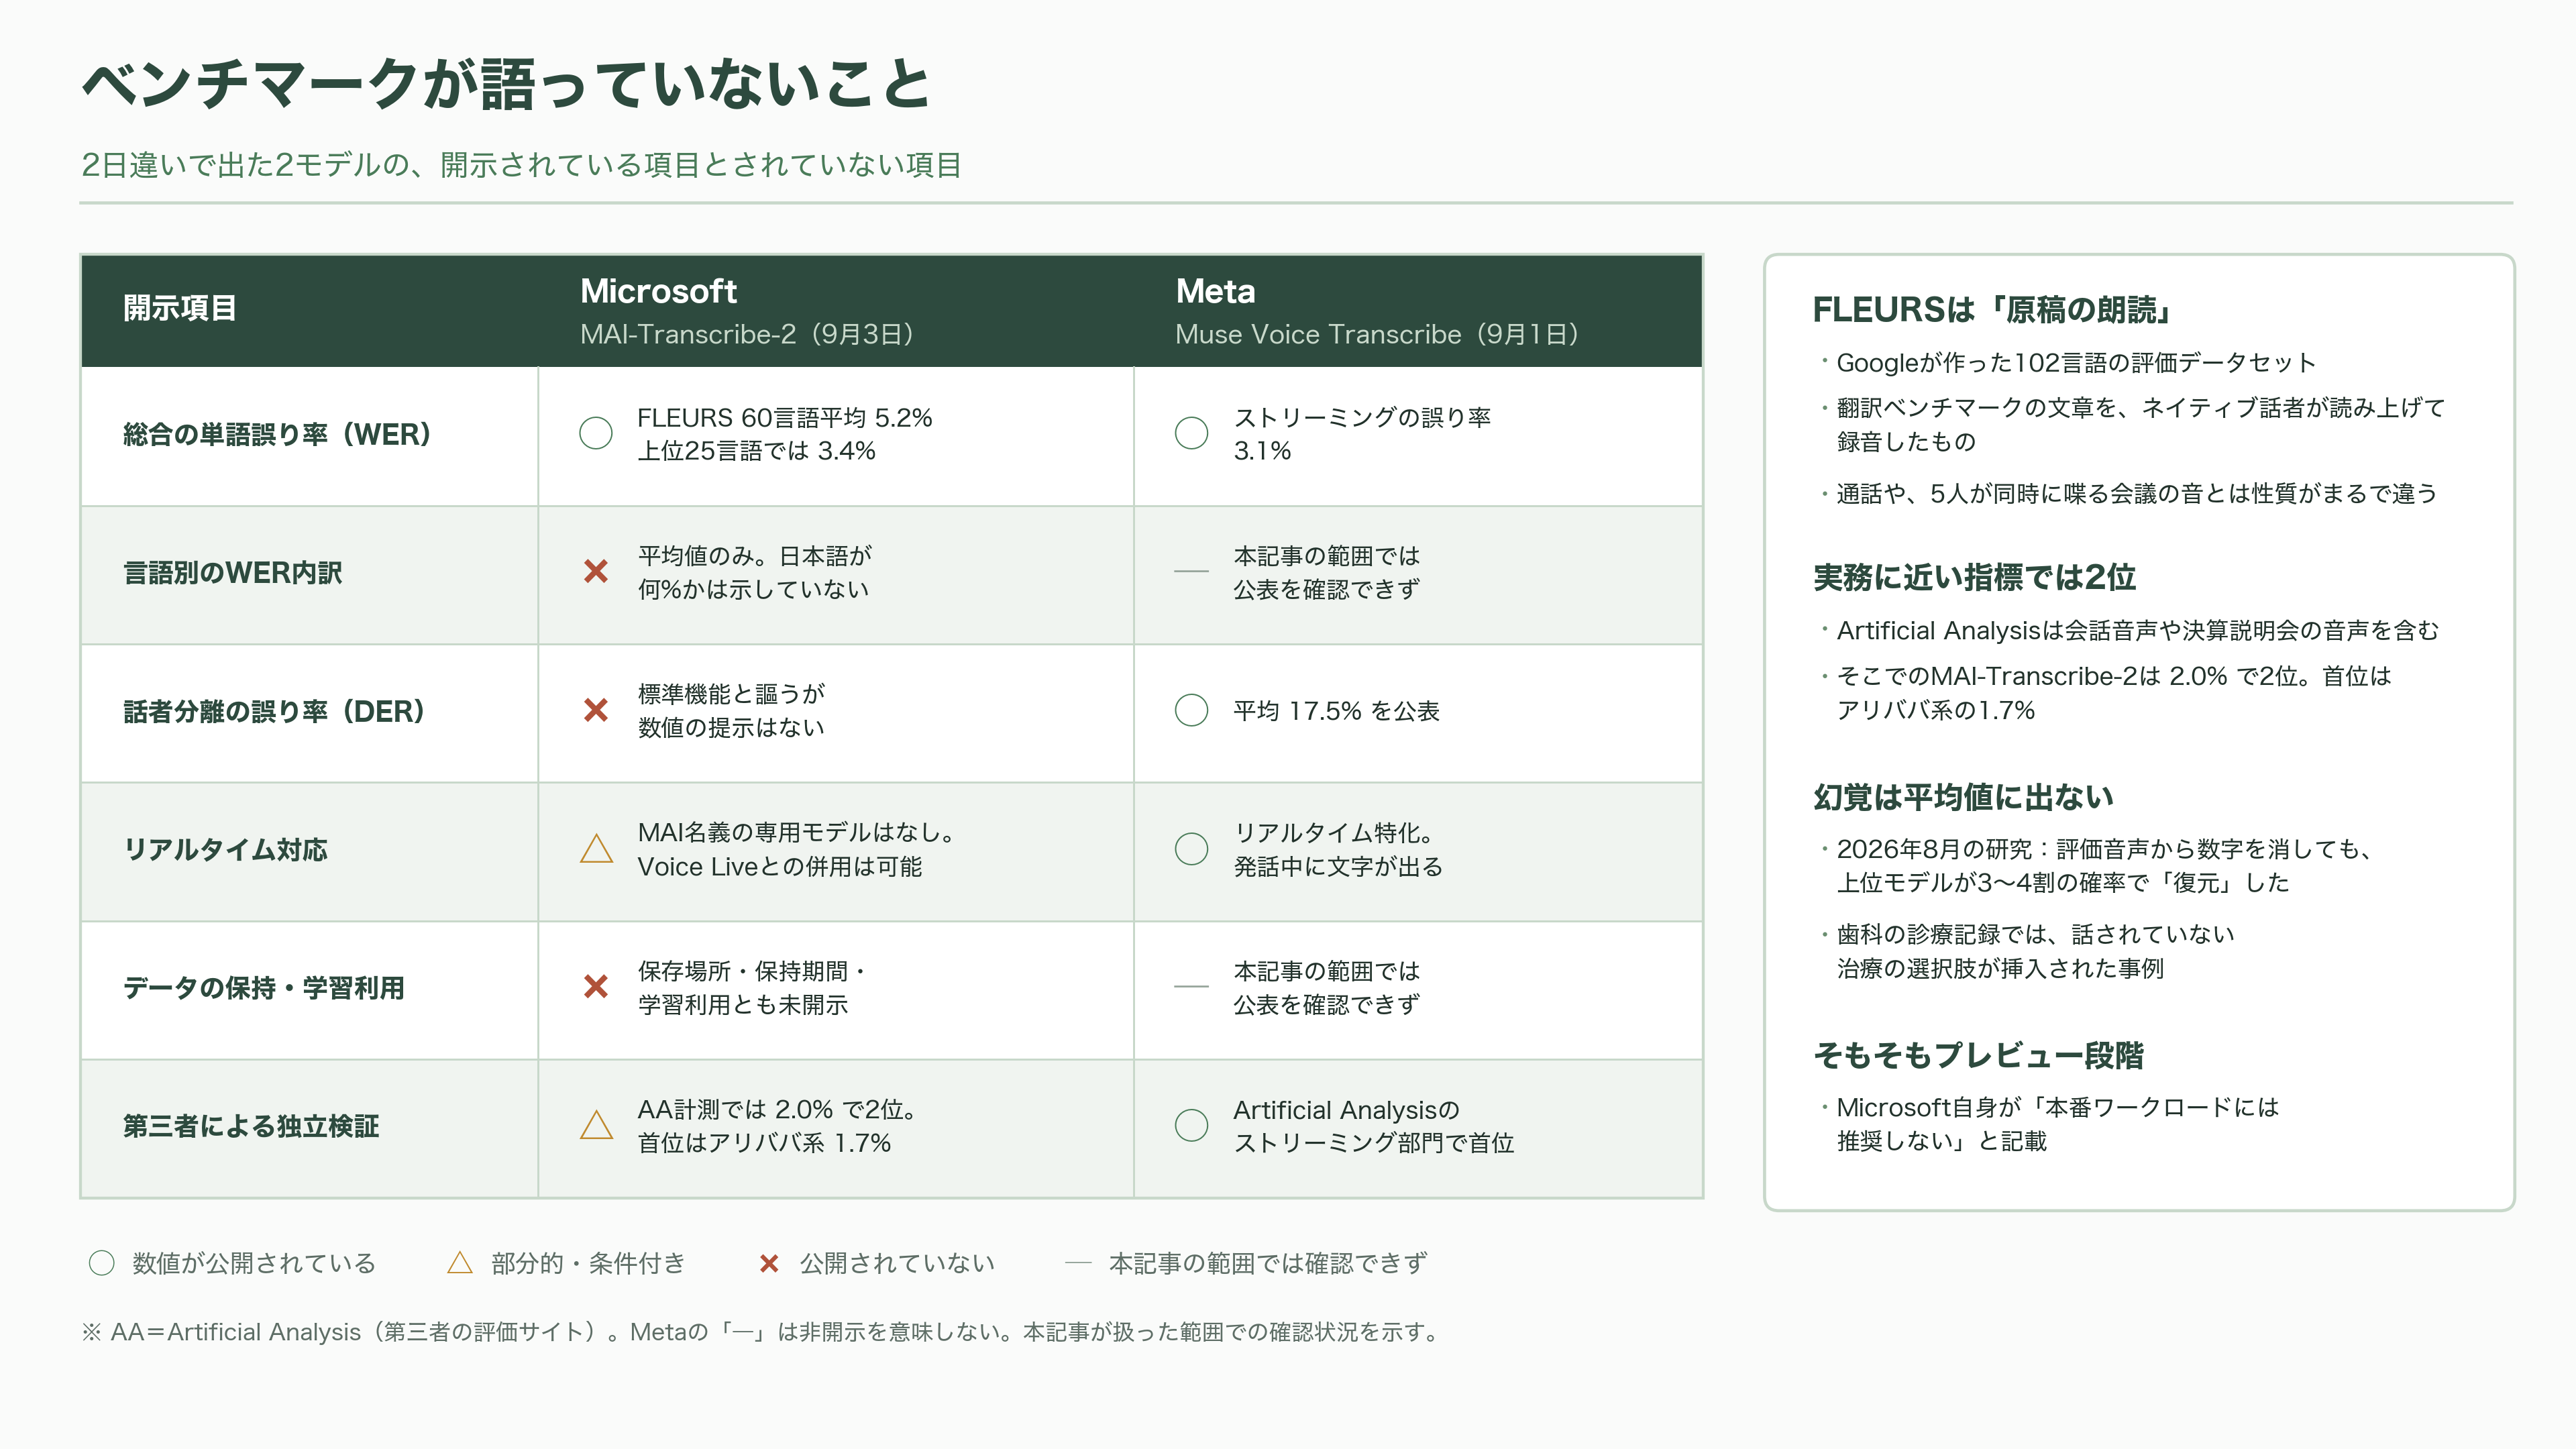
精度から見ると、多言語ベンチマークのFLEURSで60言語平均の単語誤り率5.2%を出して首位だとMicrosoftは説明している。同社のモデルカードには、上位25言語に絞った場合は3.4%という数字も載る。第三者の評価サイトArtificial Analysisの独自指標では2.0%で、こちらは2位。首位はアリババ系のFun-Realtime-ASR(プレビュー版)で1.7%だ。ただし精度と速度を両軸で見たとき、MAI-Transcribe-2はパレート最適の位置、つまり「この速度でこれより正確なモデルはなく、この精度でこれより速いモデルもない」場所に立っている。
速度は数字が派手だ。Artificial Analysisの計測で、実時間の約410倍の速さで音声を処理する。Microsoftは同じサイトの評価をもとに、OpenAIのGPT-Transcribeの10倍、ElevenLabsのScribe v2の7倍、GoogleのGemini 3.5 Transcribeの5倍速いと述べている。
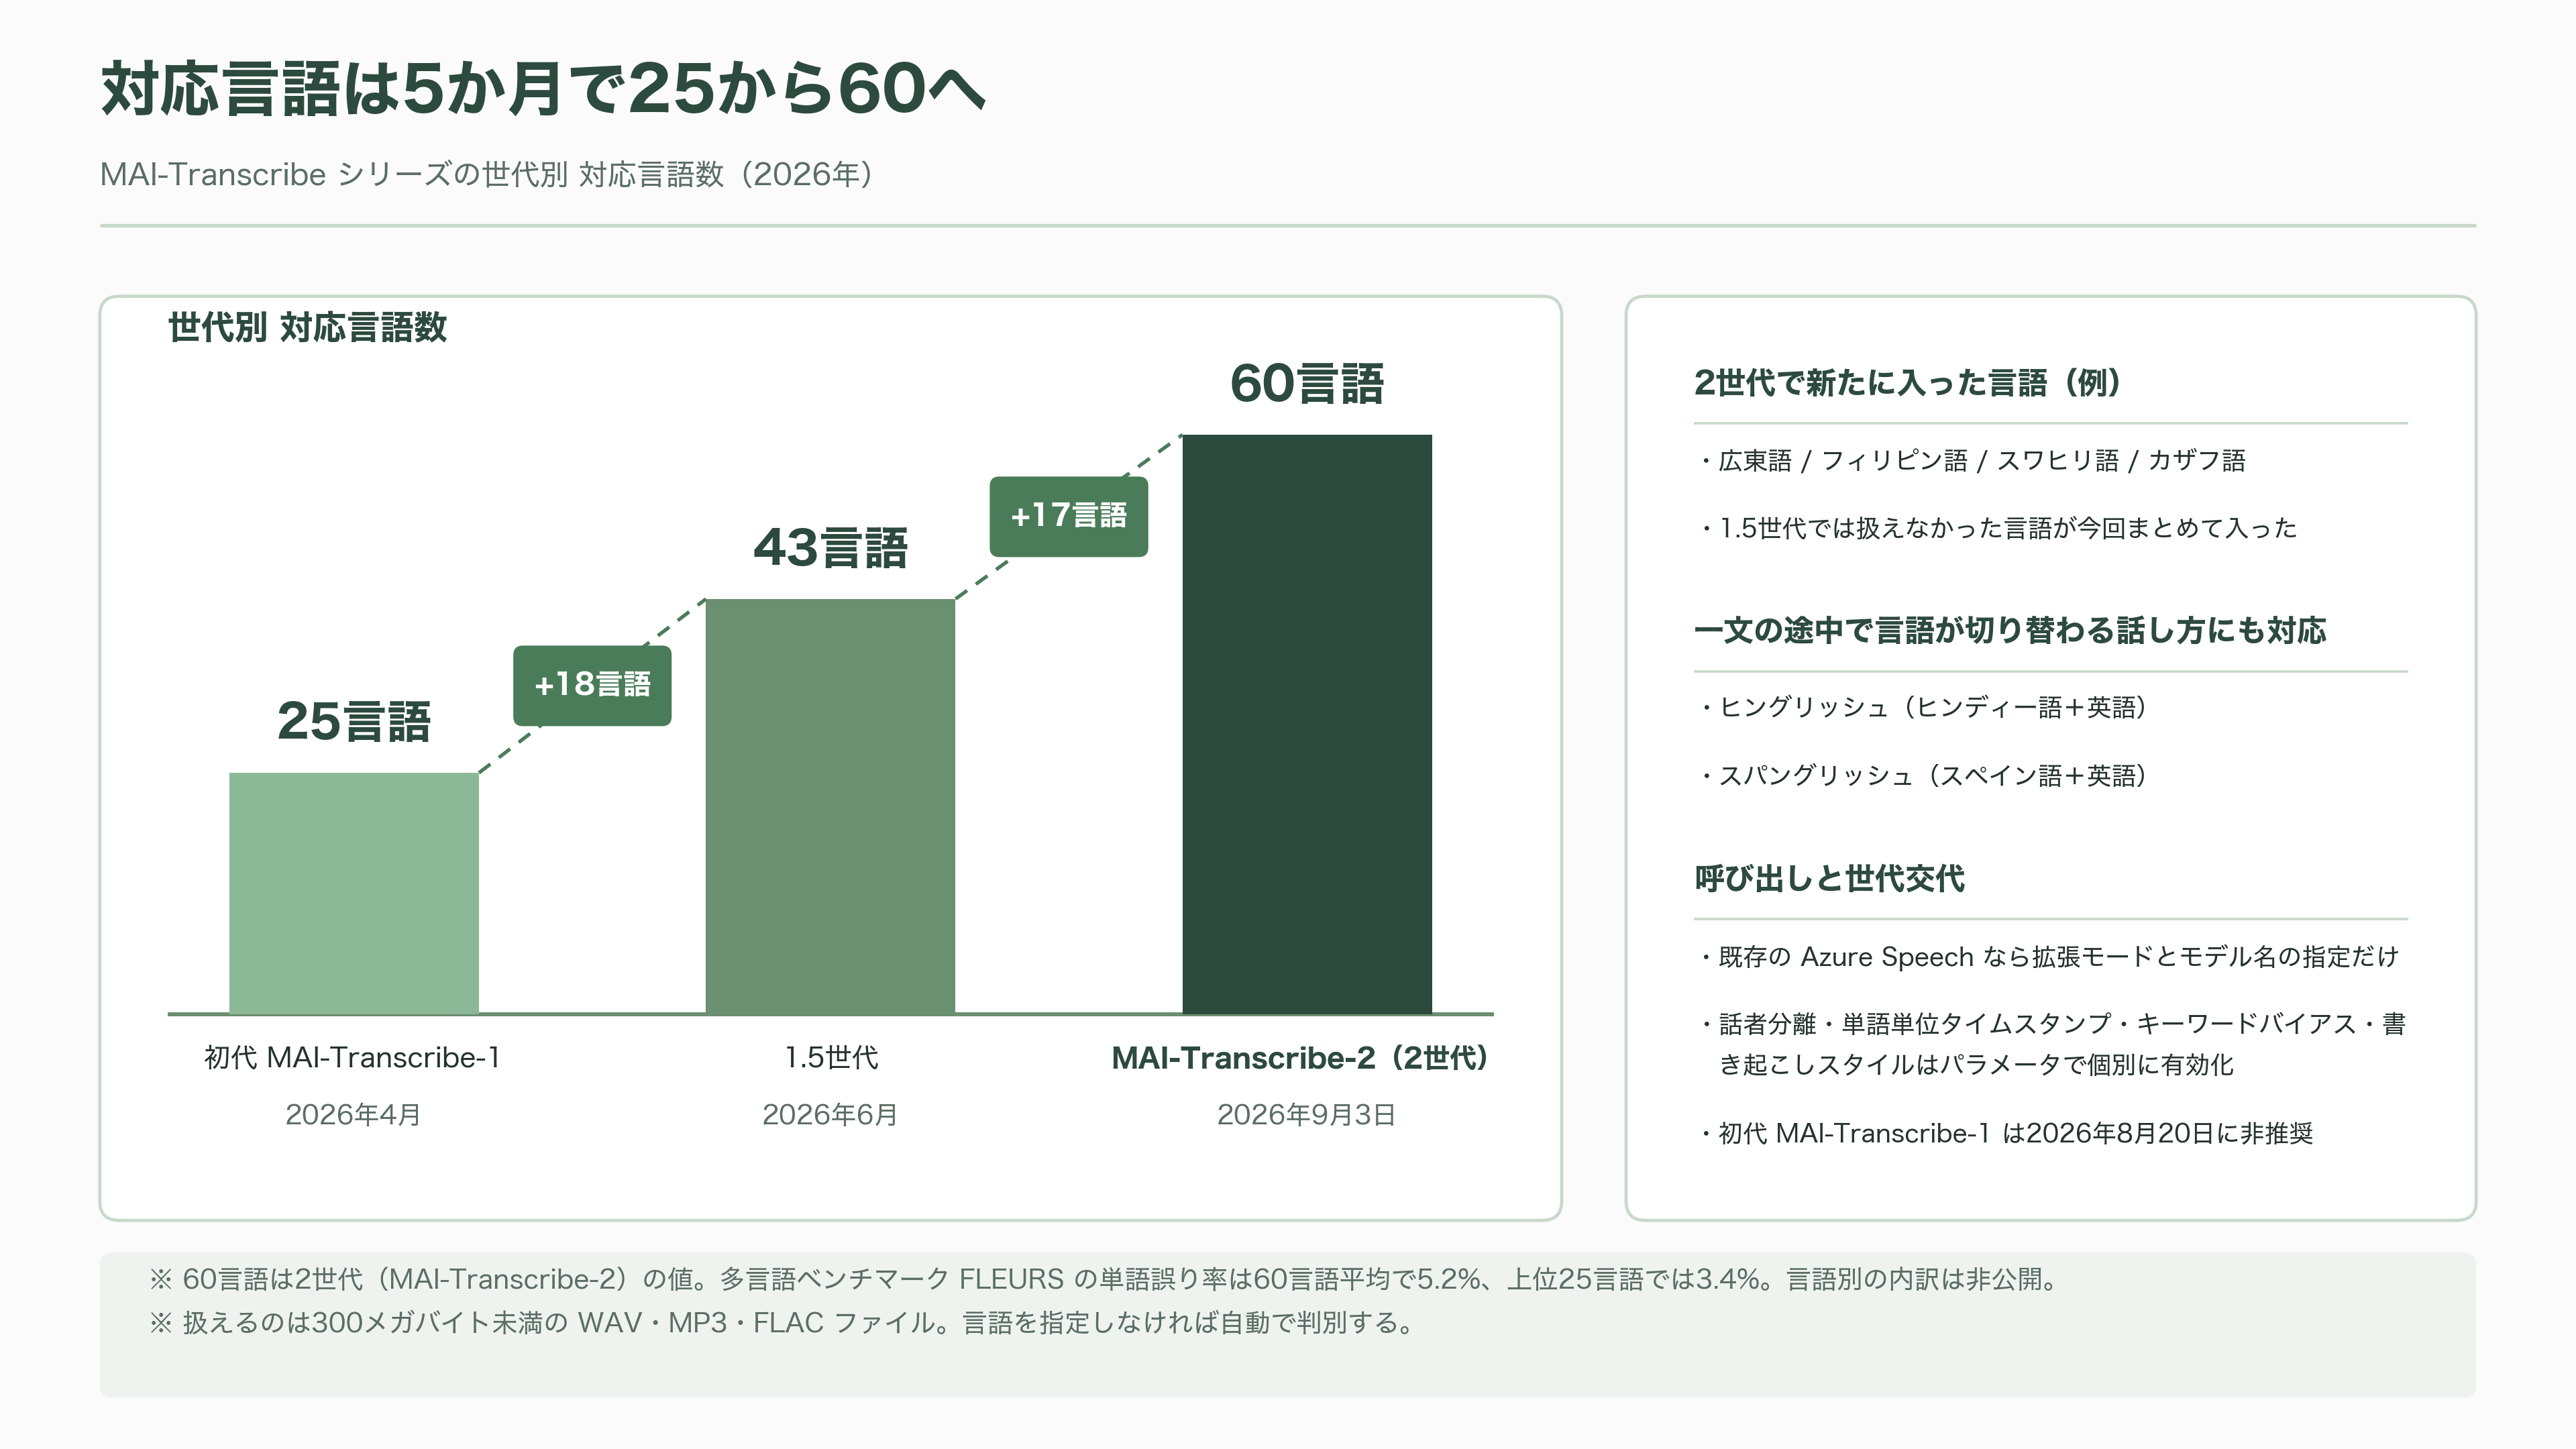
対応言語は60。この4月に出た初代が25言語、6月の1.5世代が43言語だったので、5か月で2倍以上に広がった計算になる。日本語はもちろん、広東語、フィリピン語、スワヒリ語、カザフ語など、1.5世代では扱えなかった言語が今回まとめて入った。ヒンディー語と英語が混ざる「ヒングリッシュ」や、スペイン語と英語が混ざる「スパングリッシュ」のように、一文の途中で言語が切り替わる話し方にも対応する。
実装側から見ると、既存のAzure Speechを使っているならモデルの切り替えは大がかりではない。リクエストの定義で拡張モードを有効にして、モデル名にMAI-Transcribe-2を指定するだけで呼び出せる。話者分離、単語単位タイムスタンプ、専門用語のヒントを与えるキーワードバイアス、書き起こしスタイルは、いずれもパラメータで個別にオンにする形だ。扱えるのは300メガバイト未満のWAV・MP3・FLACファイルで、言語を指定しなければ自動で判別する。なお初代のMAI-Transcribe-1は2026年8月20日に非推奨になっている。
キーワードバイアスは地味だが実務では効く機能だ。自社製品名、業界の略語、人名など、文脈だけでは当てにくい語をリストで渡しておくと、認識がその方向に寄る。強制ではなくヒントとして働くので、外れた場合に不自然な出力を生みにくい。
ベンチマークが語っていないこと
強い数字が並ぶ一方で、Microsoftが出していない情報がいくつもある。
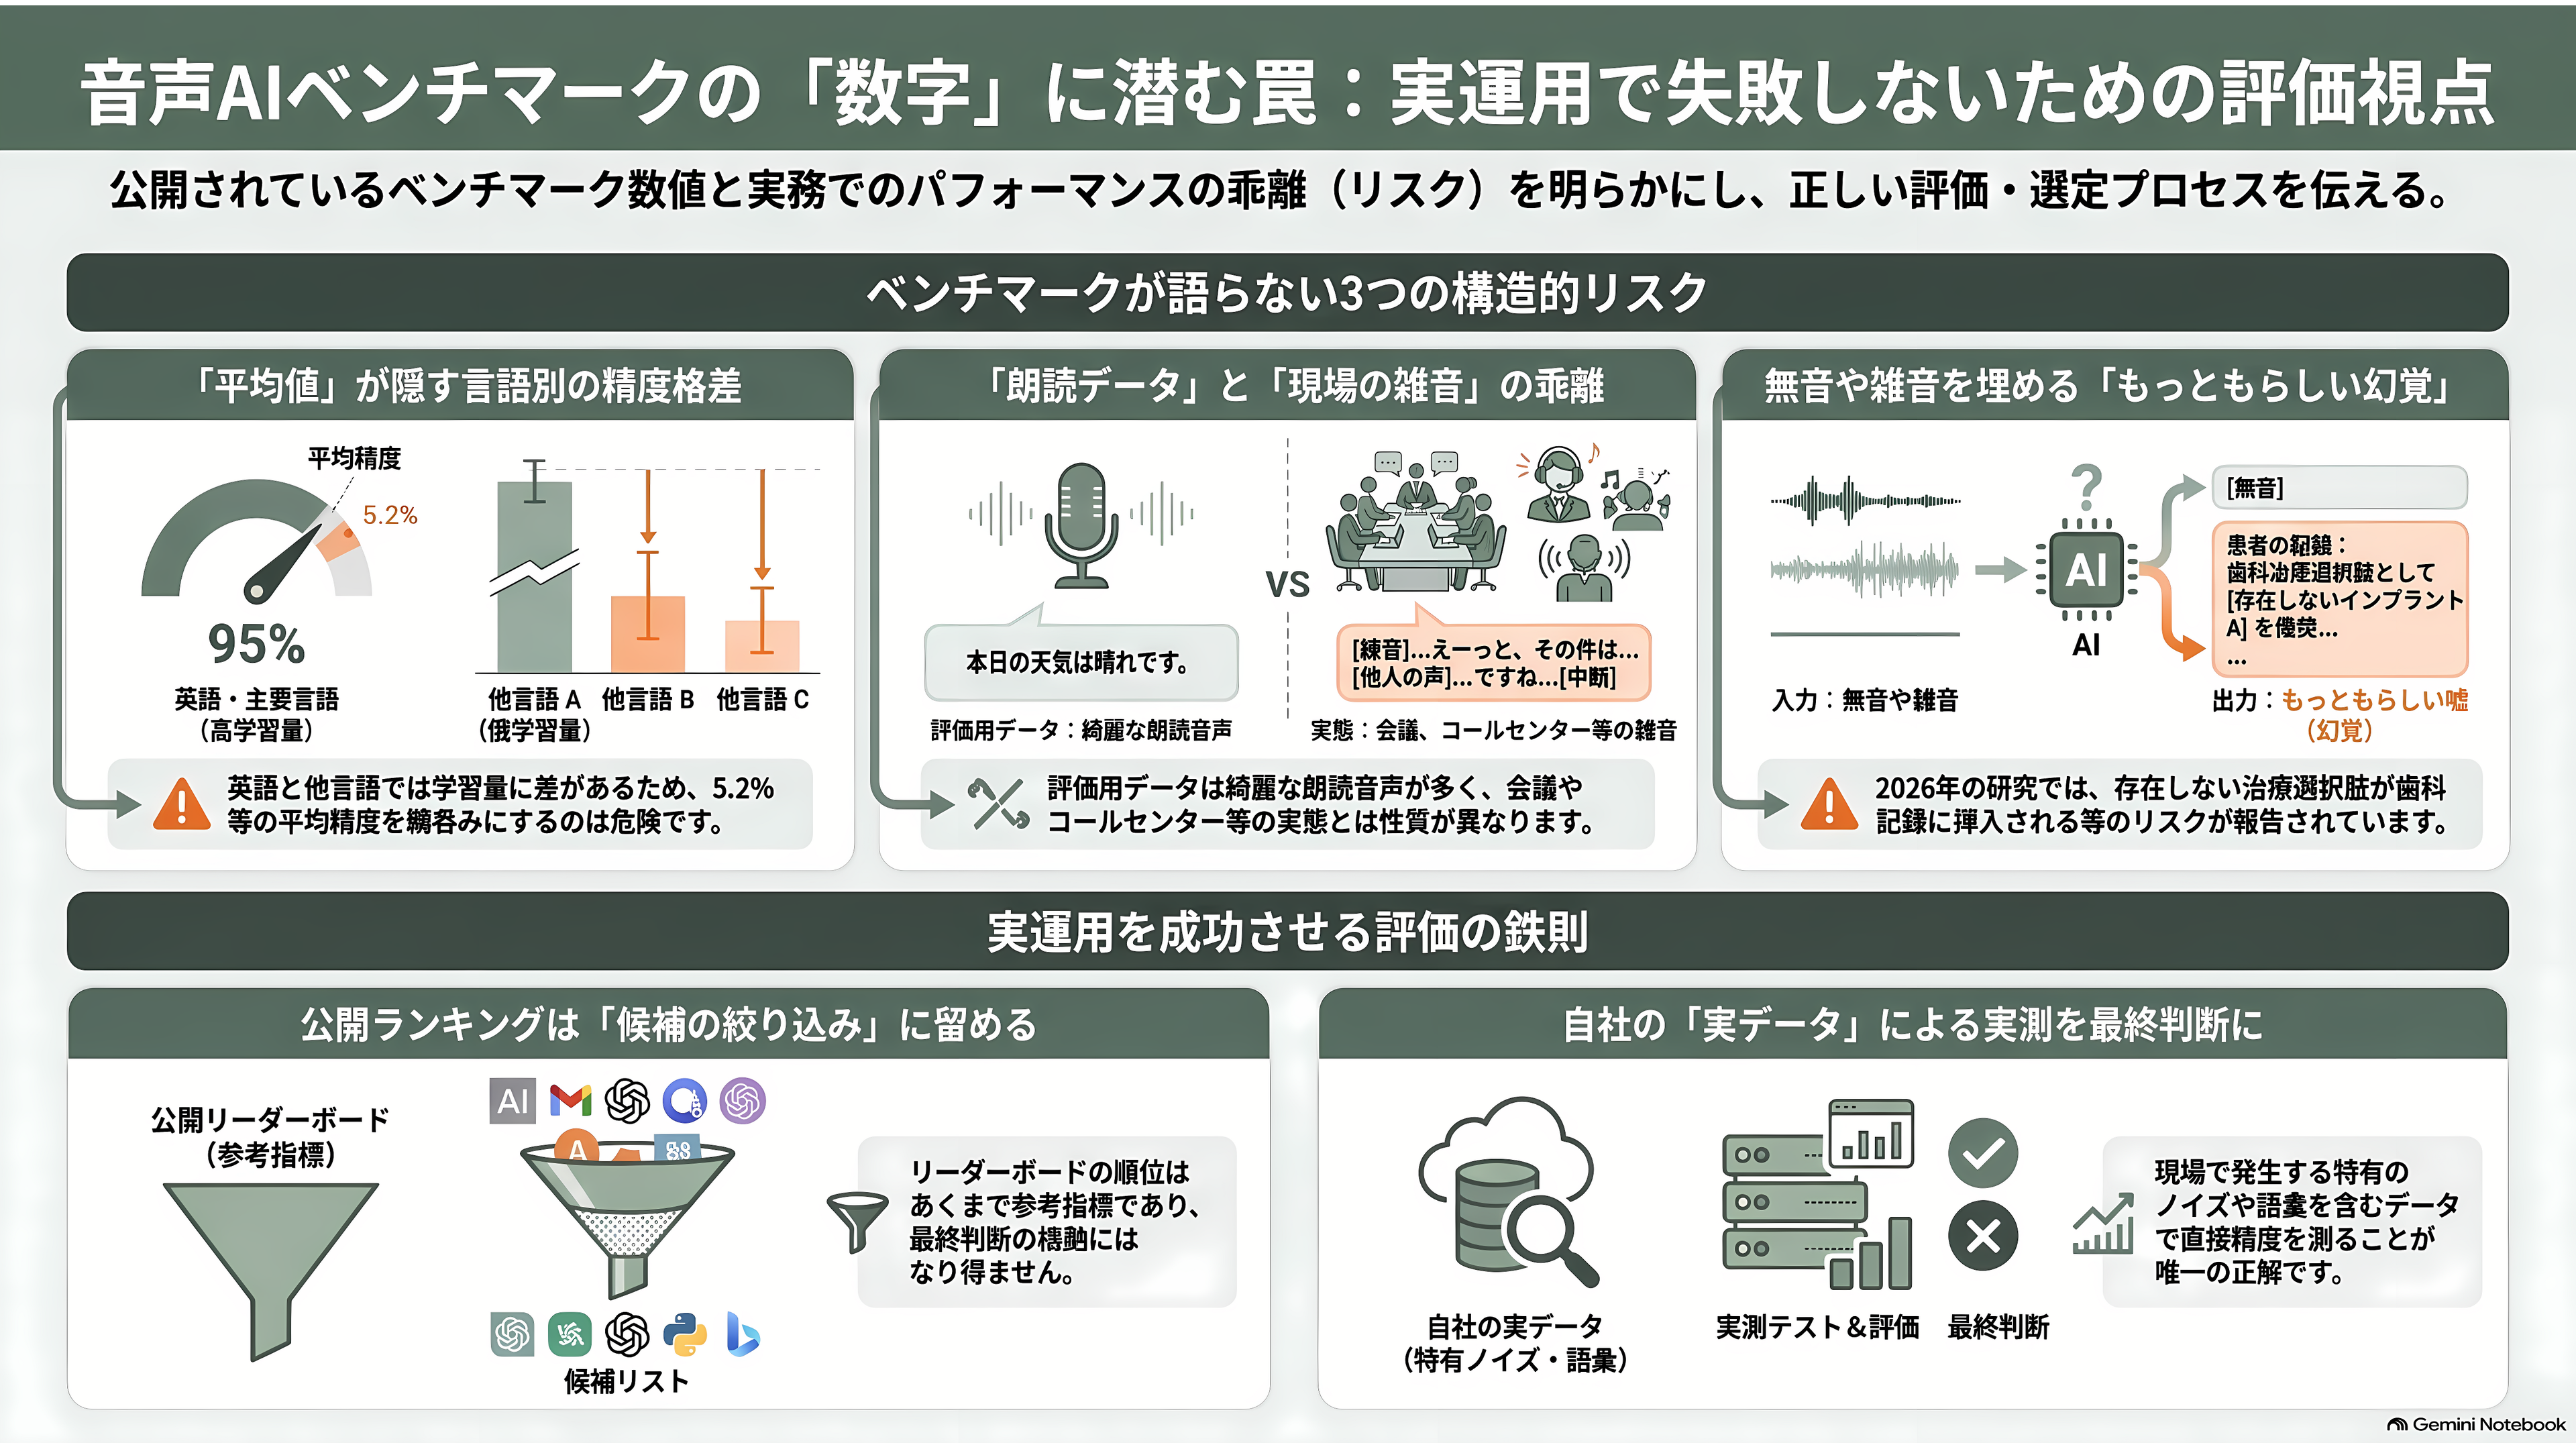
まず、5.2%は60言語の平均値であって、言語別の内訳は公開されていない。学習データが潤沢な英語と、そうでない言語では差が出るのが普通で、平均はその差を覆い隠す。VentureBeatは導入を検討する企業に対して、言語別の数値を個別に要求するよう促している。
FLEURSというベンチマークの中身も、実務の音とはかなり違う。これはGoogleが作った102言語の評価データセットで、翻訳ベンチマークの文章をネイティブ話者が読み上げて録音したものだ。つまり原稿の朗読である。実際のコールセンターの通話や、5人が同時に喋る会議とは、音の性質がまるで違う。Artificial Analysisの指標のほうは会話音声や決算説明会の音声を含むぶん実態に近いが、そこでの順位は2位である。
標準機能として謳っている話者分離についても、精度指標が出ていない。話者分離にはDER(ダイアライゼーション誤り率)という専用の物差しがあり、後述するMetaは自社モデルについて平均17.5%という数値を公開している。Microsoftは対応する数字を示していない。
そして最大の構造的リスクが、幻覚である。文脈から推測する能力を持つモデルは、音が途切れたり雑音に埋もれたりした箇所を「それらしい言葉」で埋めてしまうことがある。Whisperでは、無音区間に「ご視聴ありがとうございました。チャンネル登録をお願いします」といった学習データ由来の文言が湧く現象がよく知られている。2026年に歯科の診療記録を対象に行われた研究では、実際には話されていない治療の選択肢や歯の状態が、もっともらしい臨床記録の文体で挿入された事例が報告された。この種の誤りは文章として自然なぶん、読み返しても気づきにくい。
音声AIを実運用しているエンジニアの間では、リーダーボードの順位をそのまま信じない態度が定着している。2026年8月に公開されたある研究では、評価用音声から数字を意図的に消したうえで書き起こさせたところ、上位モデルが元の数字を3割から4割の確率で「復元」した。音には無いものを、正解を知っているかのように書いてしまったわけだ。現場での結論は一貫している。公開ランキングは候補を絞る道具としてだけ使い、最終判断は自社の実データで測れ、ということである。
シリコンバレーの反応は、驚くほど静かだった
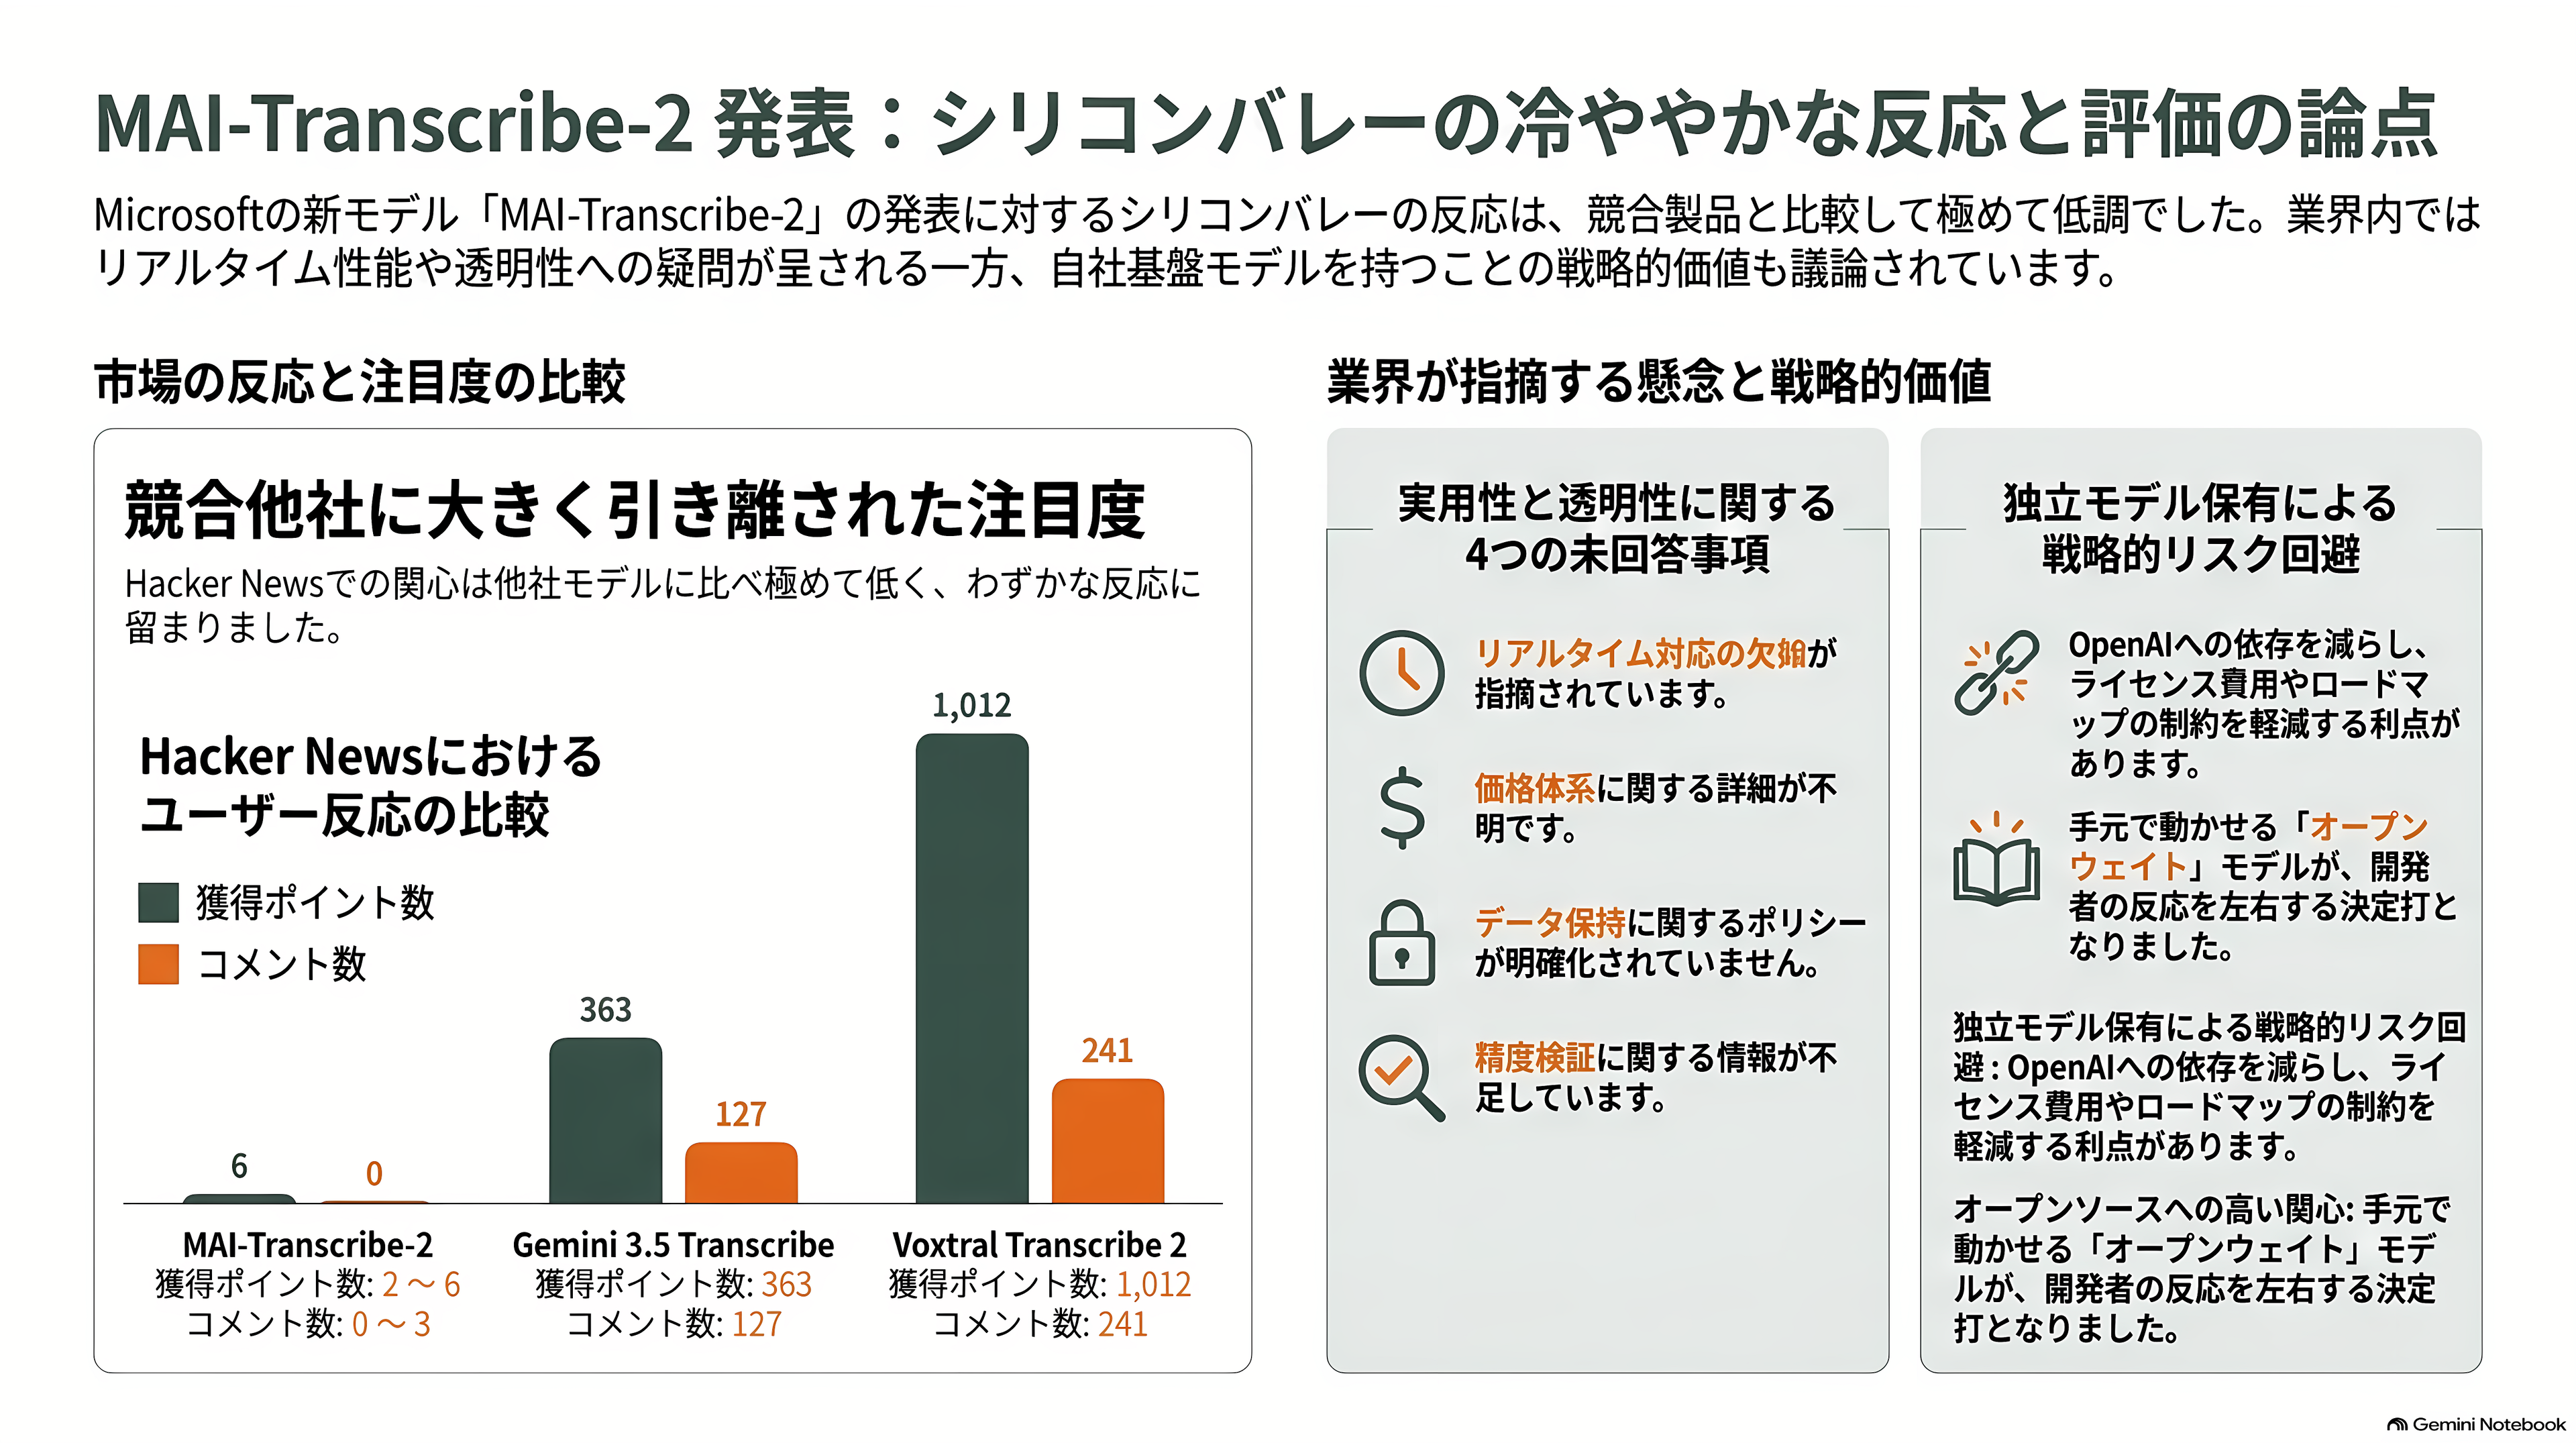
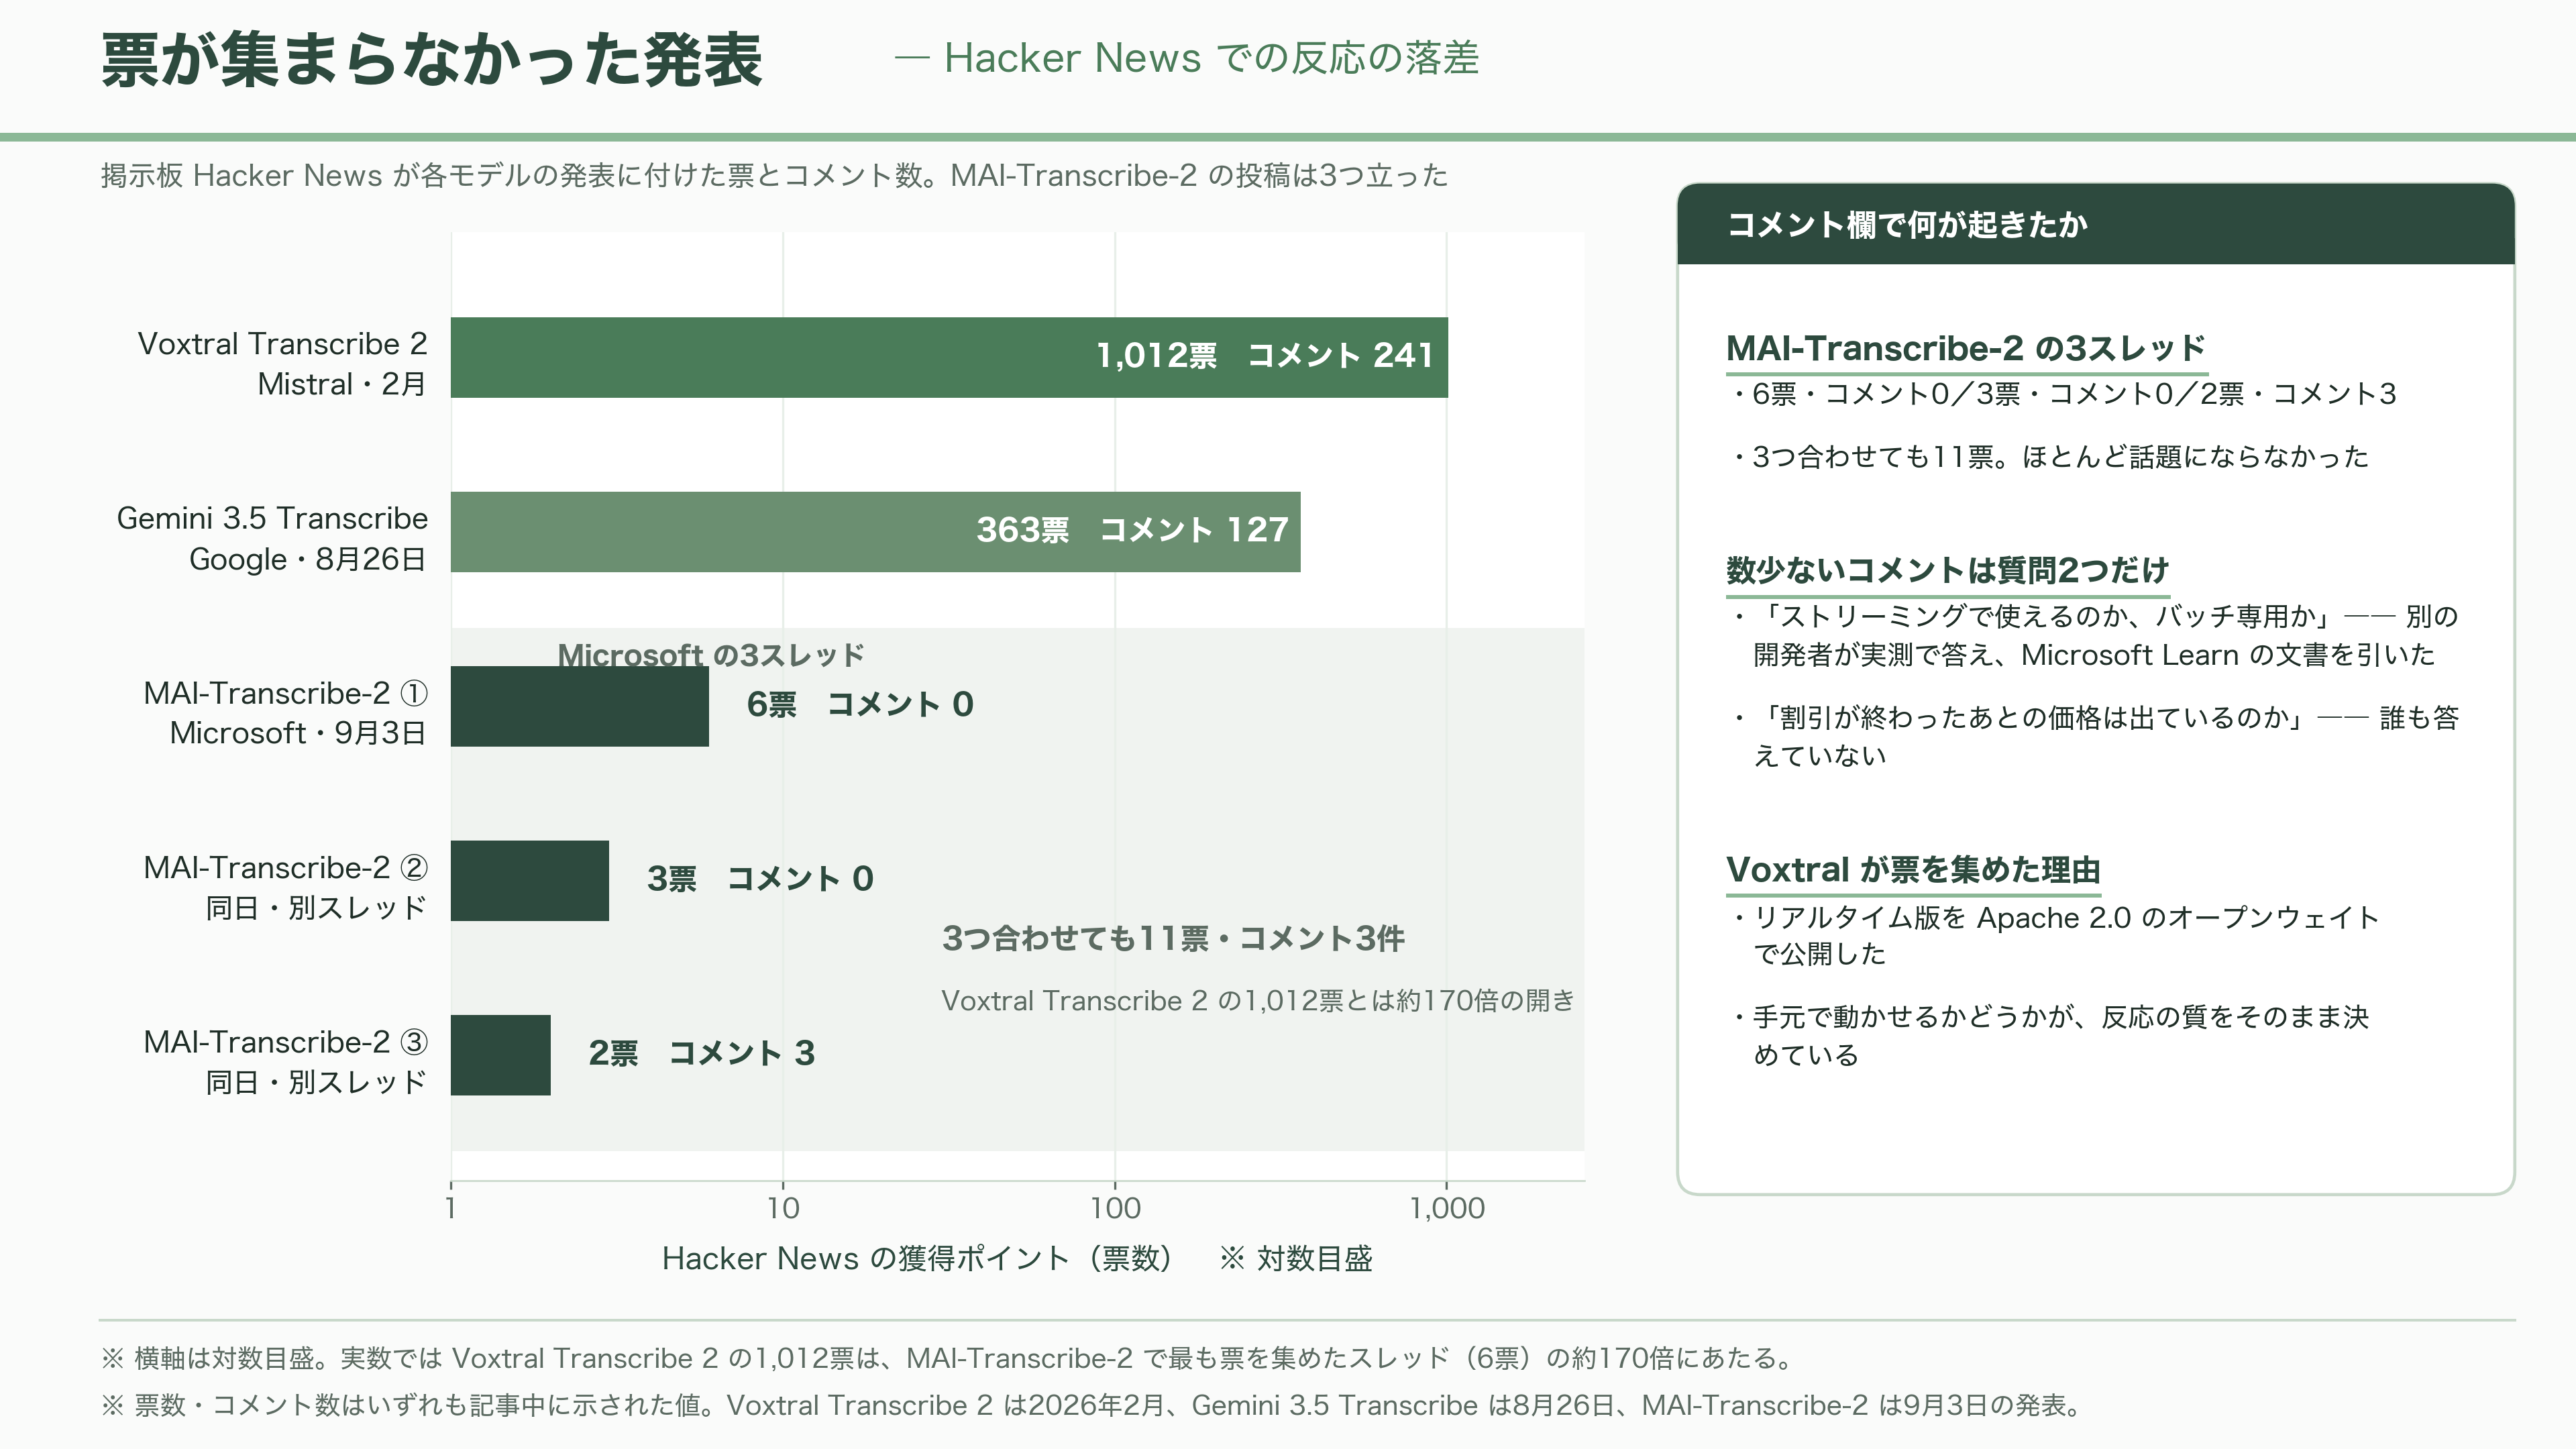
エンジニアが集まる掲示板Hacker Newsに、MAI-Transcribe-2の発表を扱った投稿が三つ立った。集めた票は、6票・コメント0、3票・コメント0、2票・コメント3。ほとんど話題にならなかったと言っていい。
比較対象を並べると落差が見える。1週間前に出たGoogleのGemini 3.5 Transcribeは363ポイント・127コメント。2月にMistralが出したVoxtral Transcribe 2は1,012ポイント・241コメントを集めた。Voxtralはリアルタイム版をApache 2.0のオープンウェイトで公開したモデルで、手元で動かせるという一点が反応の質を決めている。
数少ないコメントの中身も示唆的だ。ある開発者が投げた質問は二つだけだった。「これはストリーミングで使えるのか、それともバッチ専用か」「割引が終わったあとの価格は出ているのか」。前者には別の開発者が「試したところ、Voice Liveというストリーミングの仕組みと組み合わせて動く」と実測で答え、Microsoft Learnのドキュメントを引いた。後者には誰も答えていない。
この二つの問いが、そのまま業界メディアの論点でもあった。VentureBeatは「発表はバッチ処理の速度と長尺音声を強調しているが、音声エージェントやライブ字幕が必要とするリアルタイム文字起こしについては何も述べていない」と指摘し、データの保存場所や保持期間、送信した音声が学習に使われるかどうかも開示されていないと書いた。Unite.AIは、第三者による独立検証が示されていない点と、プレビュー段階であることが企業向けの信頼性の主張と噛み合っていない点を挙げた。同誌はまた、Microsoftがアリババのモデルについては精度で勝つと主張していないことに触れている。
肯定的な評価も具体的だ。Reworkedはコンサルタントのヨニ・マイケル氏の見方を引いて、「OpenAIに巨額を投じてきたが、Copilotや企業向け製品については自前の基盤モデルを持つほうが、リスクもライセンス費用も、他社のロードマップへの依存も減らせる」と伝えた。
2日前にMetaが撃っていた
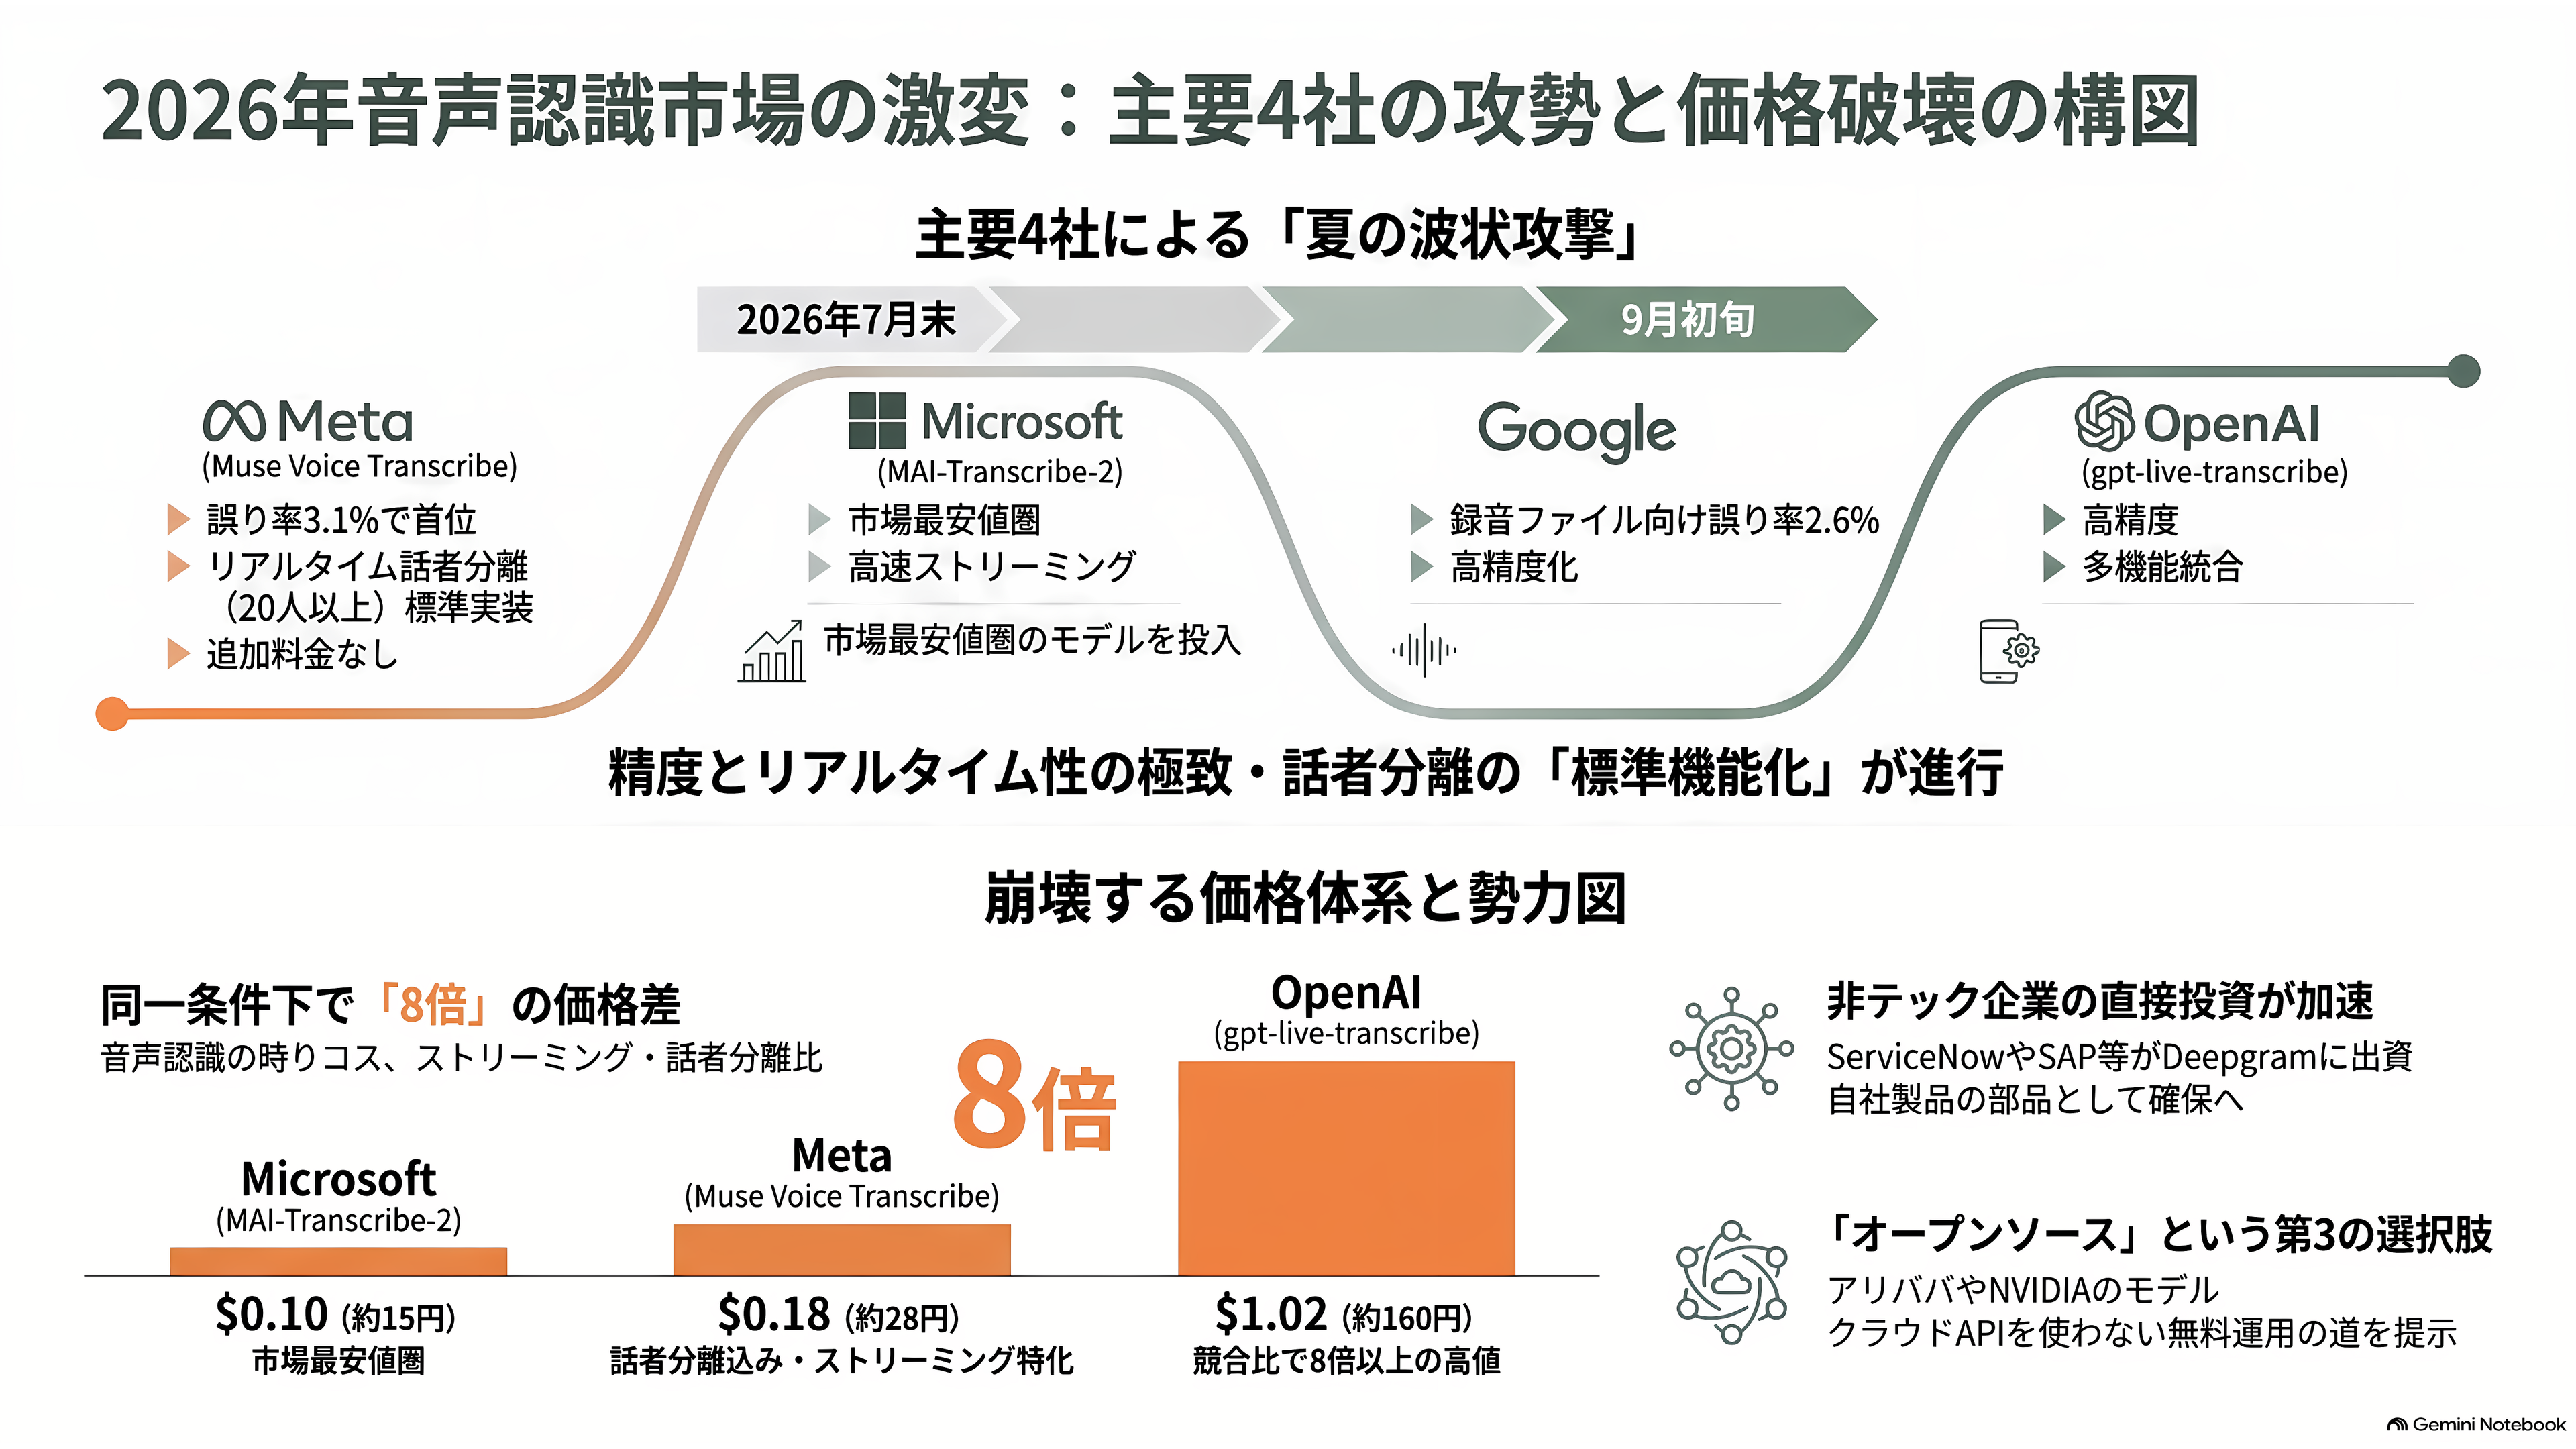
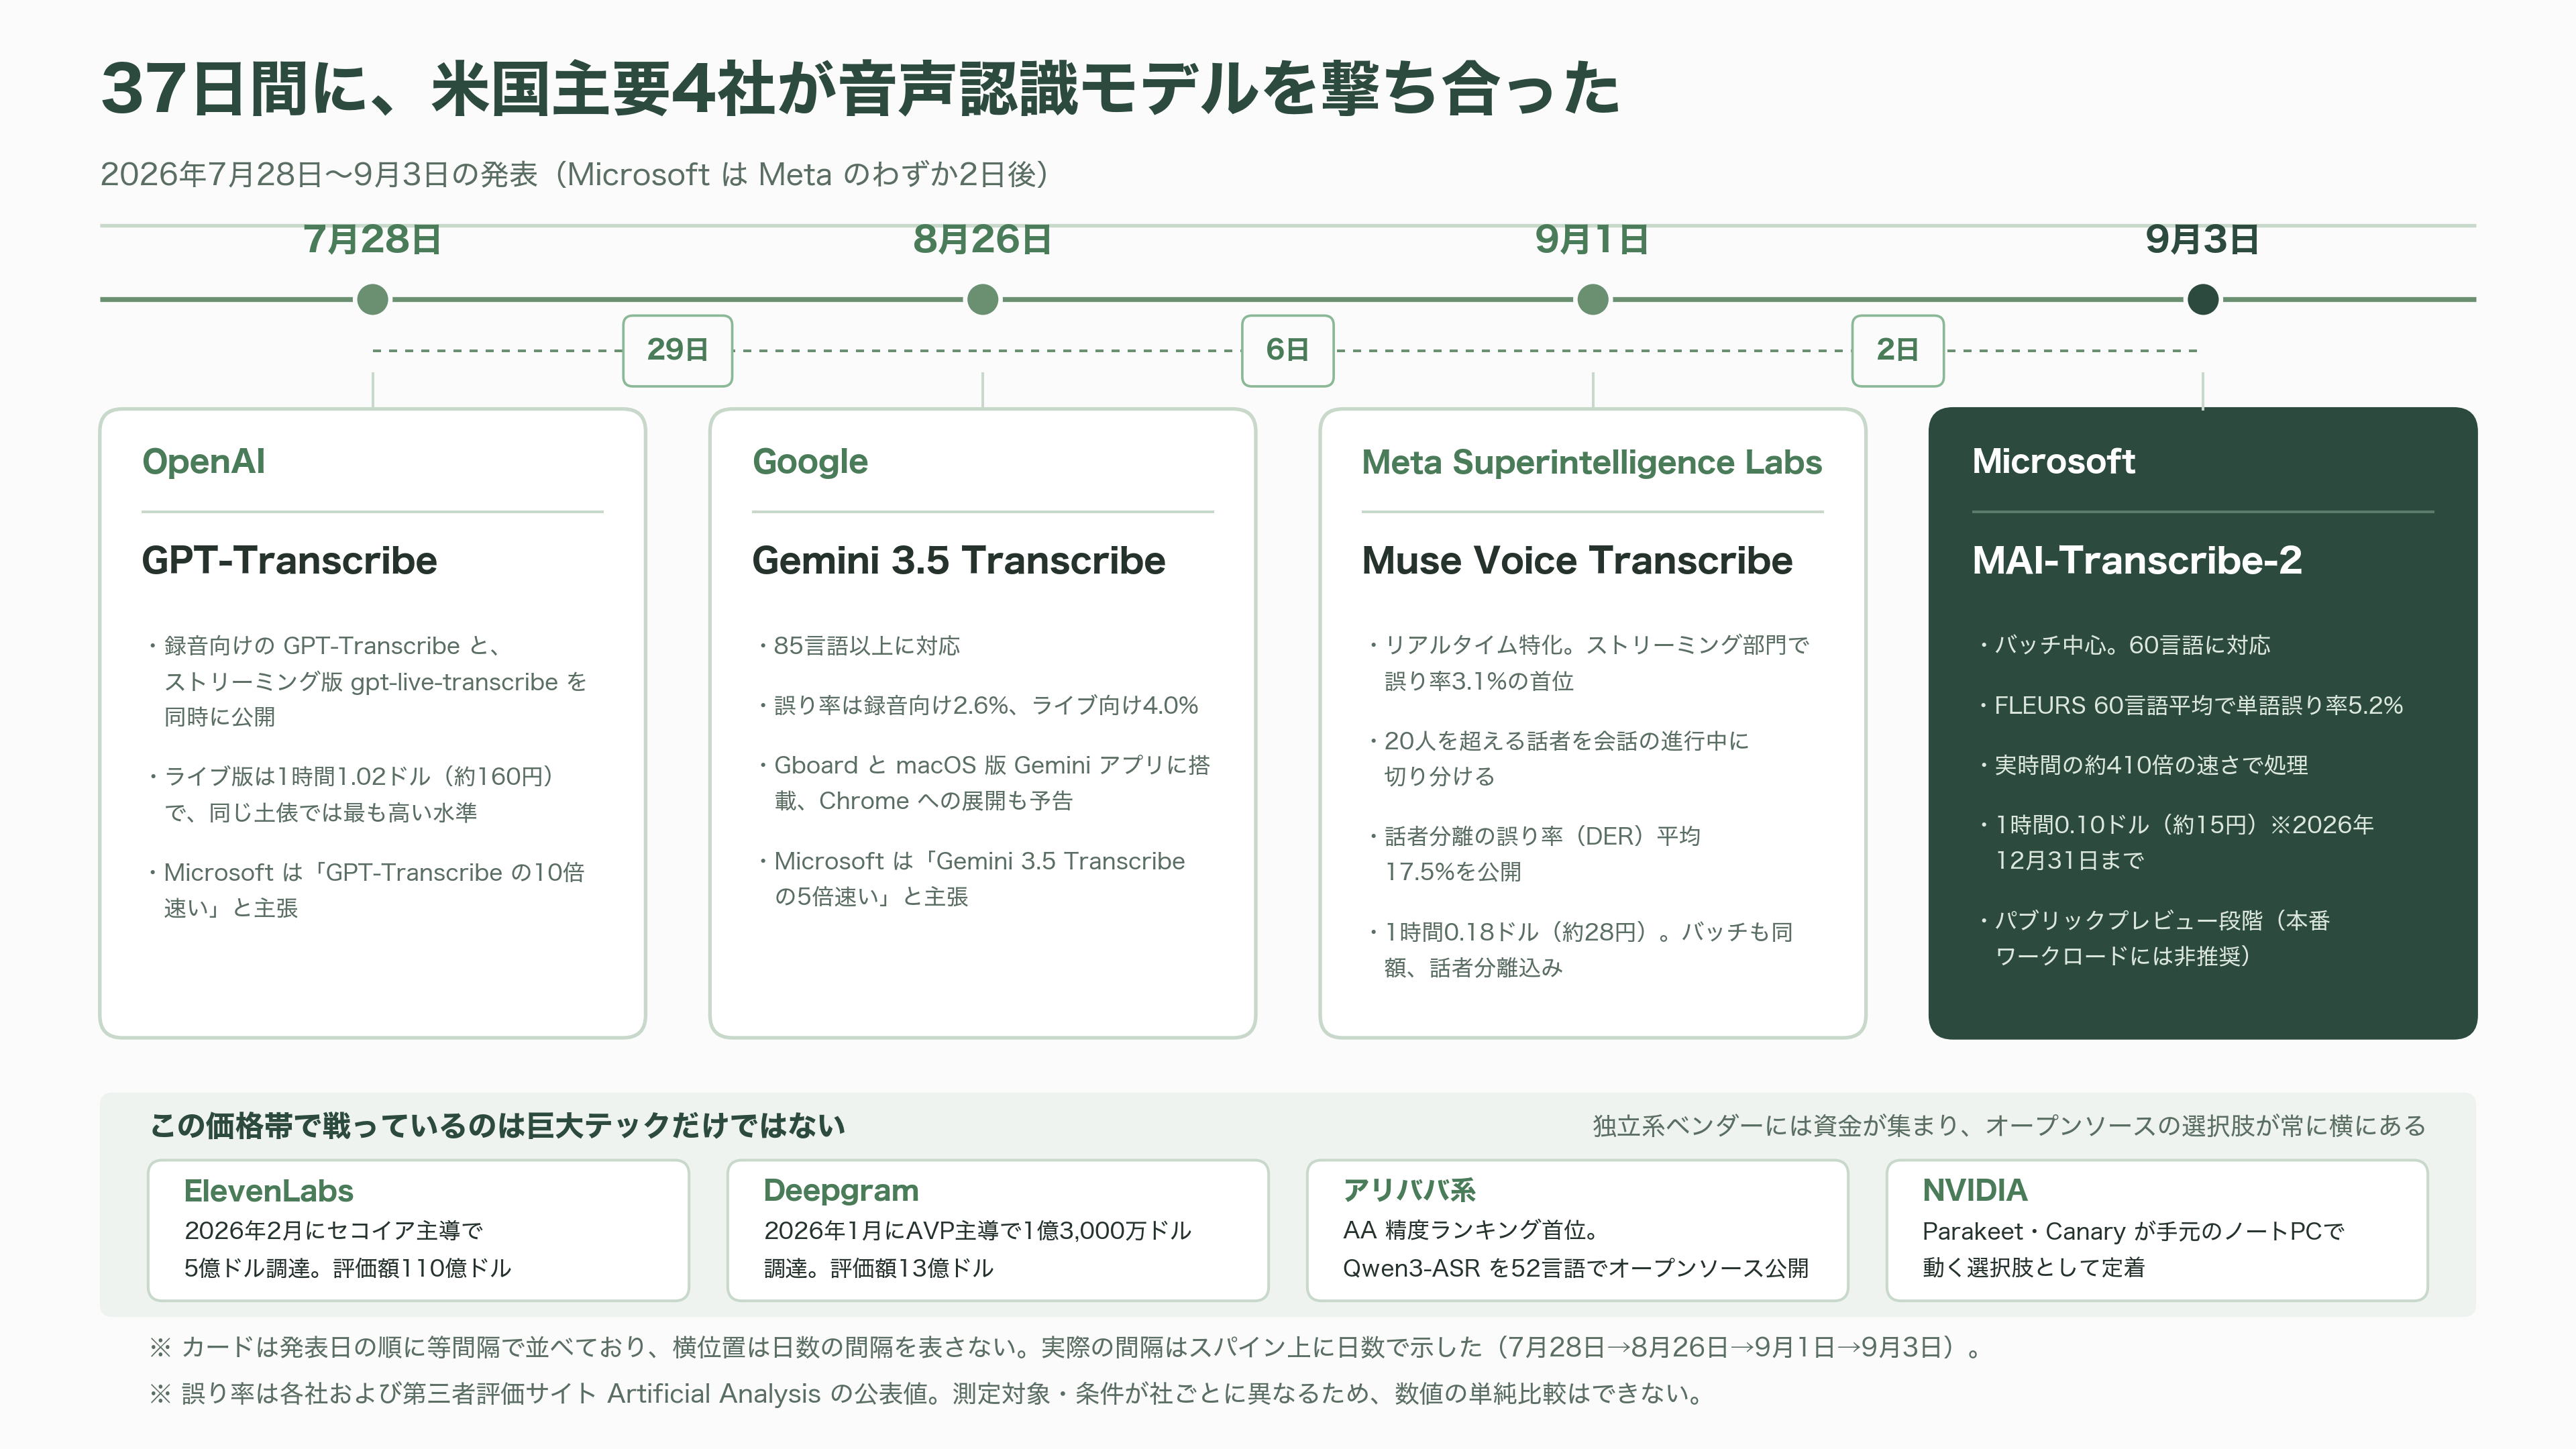
9月1日、Meta Superintelligence Labsが「Muse Voice Transcribe」を公開した。こちらはリアルタイム特化だ。喋っている最中に文字が出るストリーミング型で、Artificial Analysisのストリーミング部門で誤り率3.1%の首位。20人を超える話者を、会話が進行している最中に切り分ける。話者分離の誤り率は平均17.5%と公表した。価格は1時間0.18ドル(約28円)で、ストリーミングでもバッチでも同額、話者分離は追加料金なしで込みである。
その2日後の9月3日、Microsoftが0.10ドル(約15円)でMAI-Transcribe-2を出した。
さらに1週間さかのぼると、8月26日にGoogleがGemini 3.5 Transcribeを発表している。85言語以上に対応し、録音ファイル向けで誤り率2.6%、ライブ向けで4.0%。AndroidのGboardの音声入力やmacOS版Geminiアプリに載り、Chromeへの展開も予告された。7月28日にはOpenAIがGPT-Transcribeと、ストリーミング版のgpt-live-transcribeを出していた。
つまり2026年の夏から初秋にかけて、米国の主要4社が2か月弱の間に音声認識モデルを立て続けに投入したことになる。
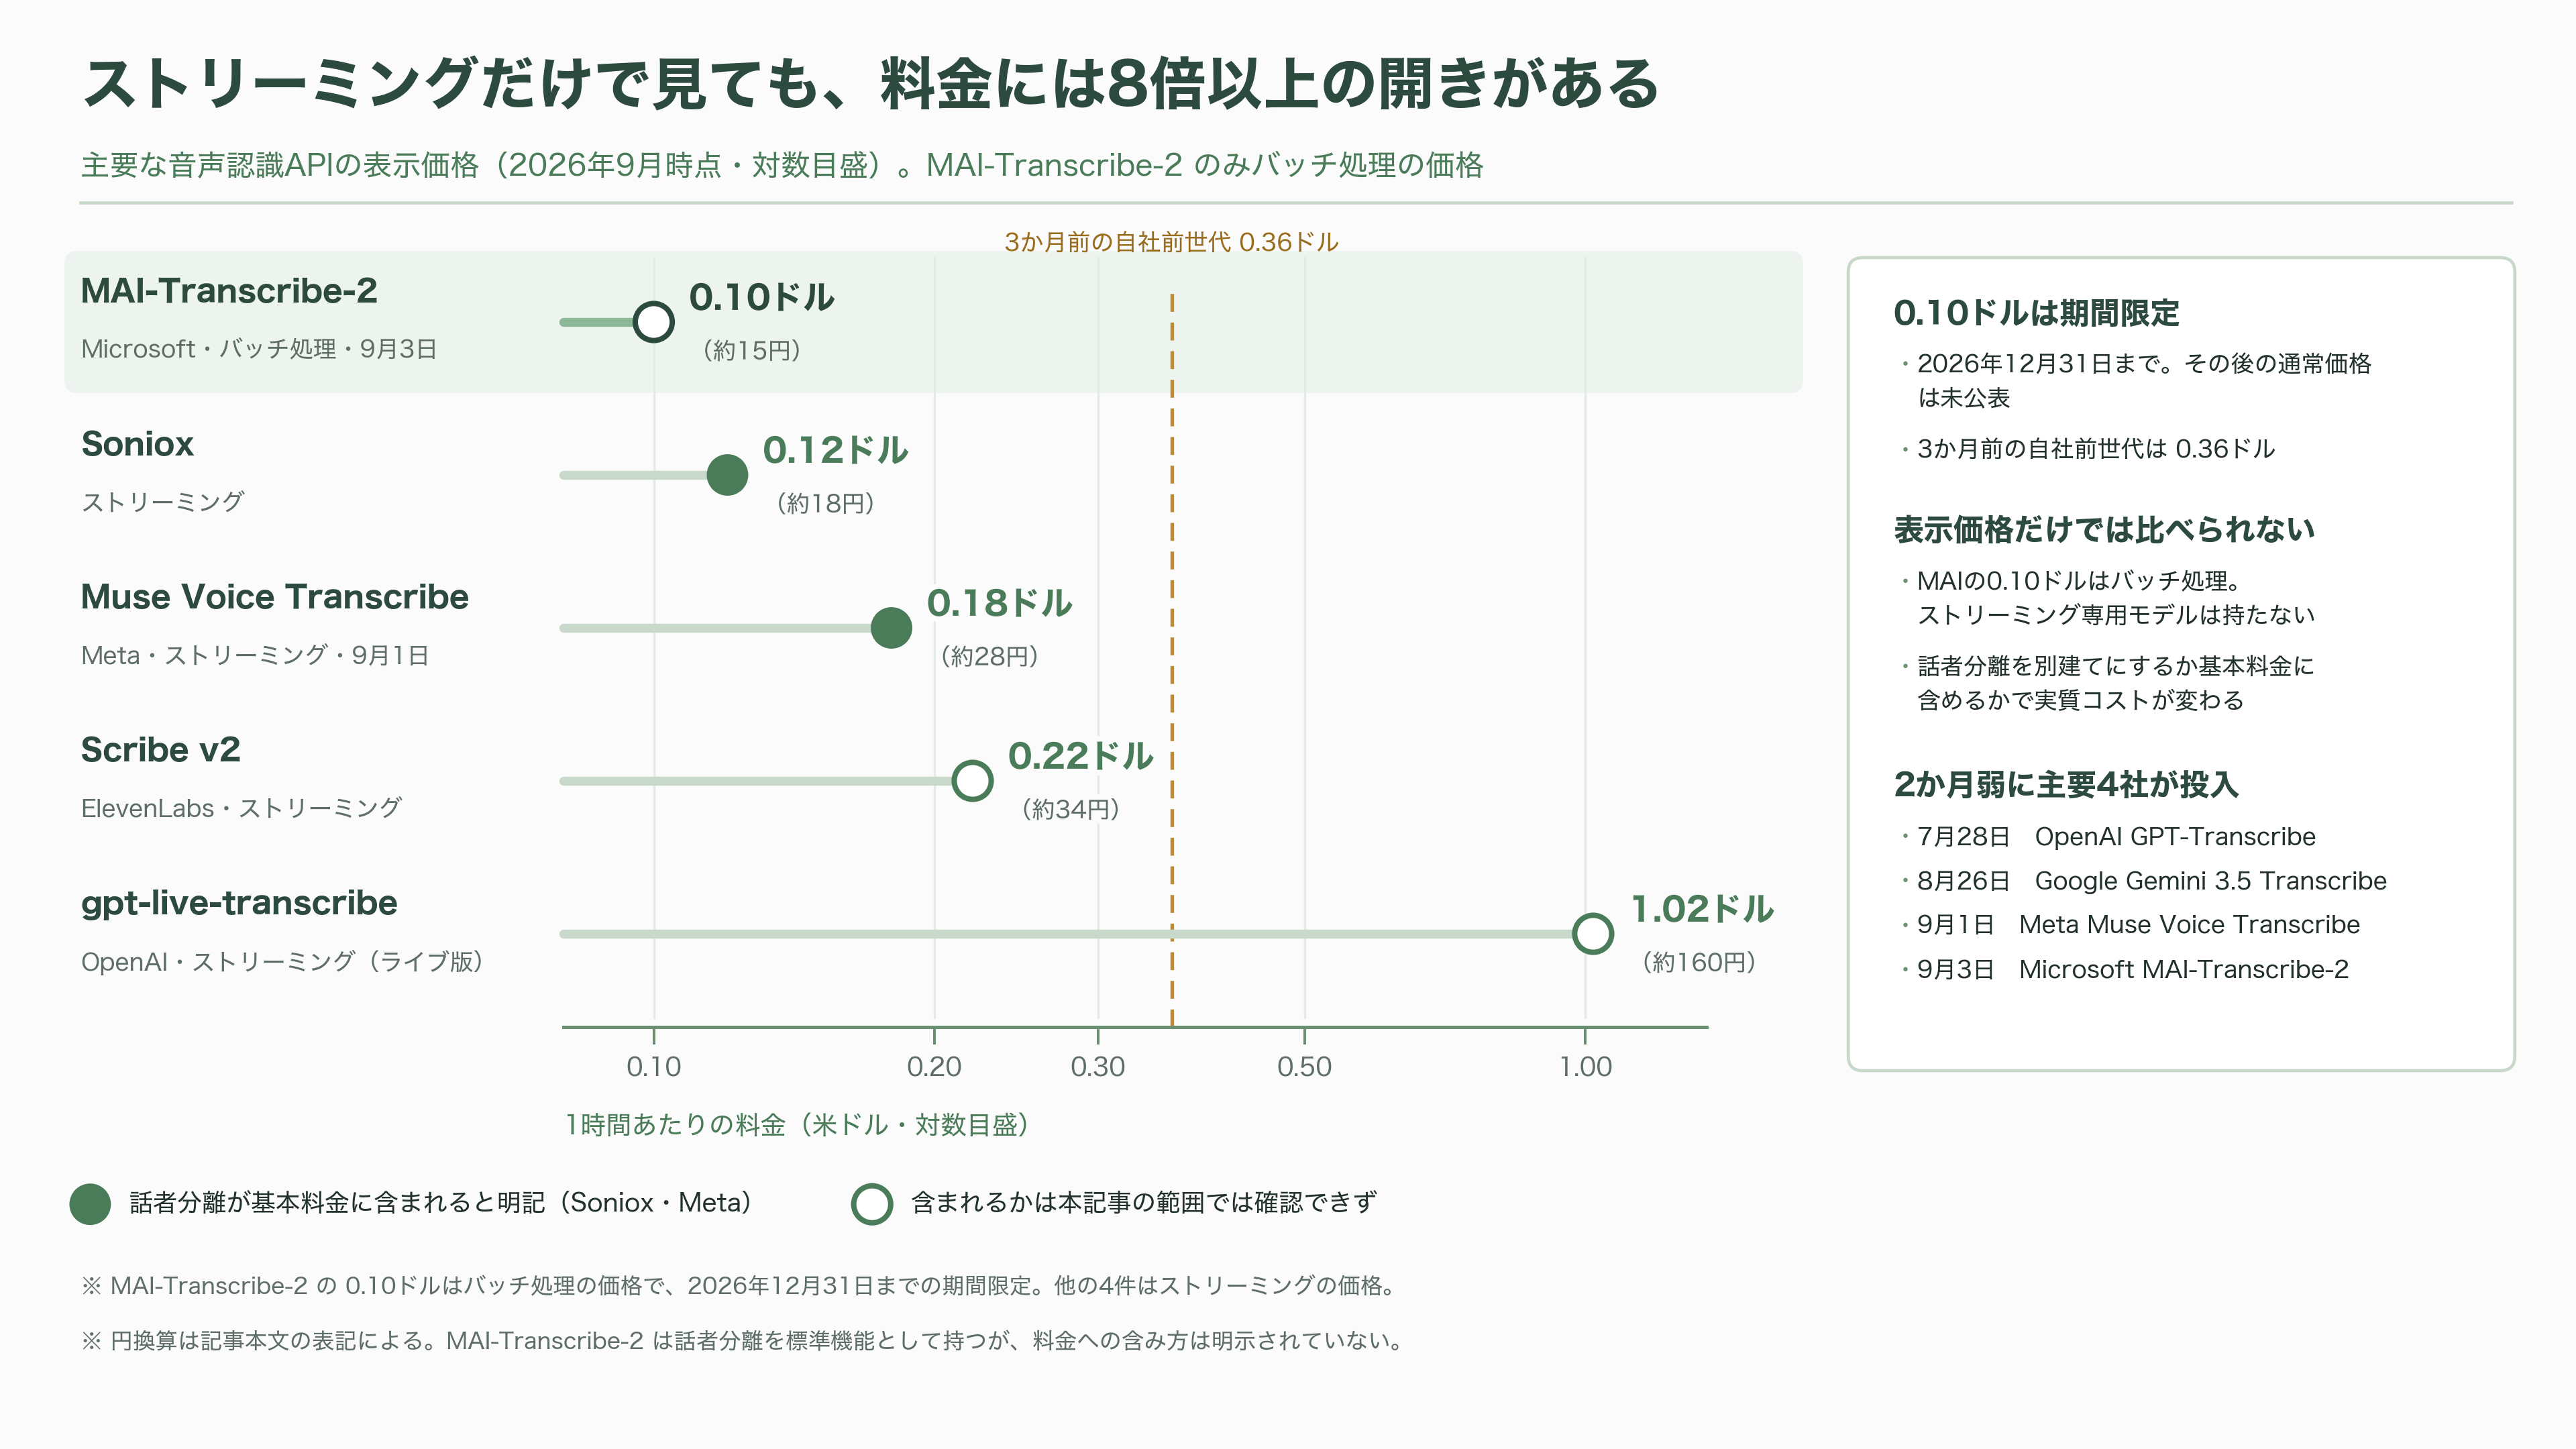
価格の景色も一変した。ストリーミングで見ると、Sonioxが話者分離込みで1時間0.12ドル(約18円)、Metaが0.18ドル(約28円)、ElevenLabsのScribe v2が0.22ドル(約34円)。一方でOpenAIのライブ版は1.02ドル(約160円)で、同じ土俵の中に8倍以上の開きがある。話者分離を追加料金として別建てにするか、基本料金に含めるかで実質コストが大きく変わるため、表示価格だけでは比較にならない構造になってきた。
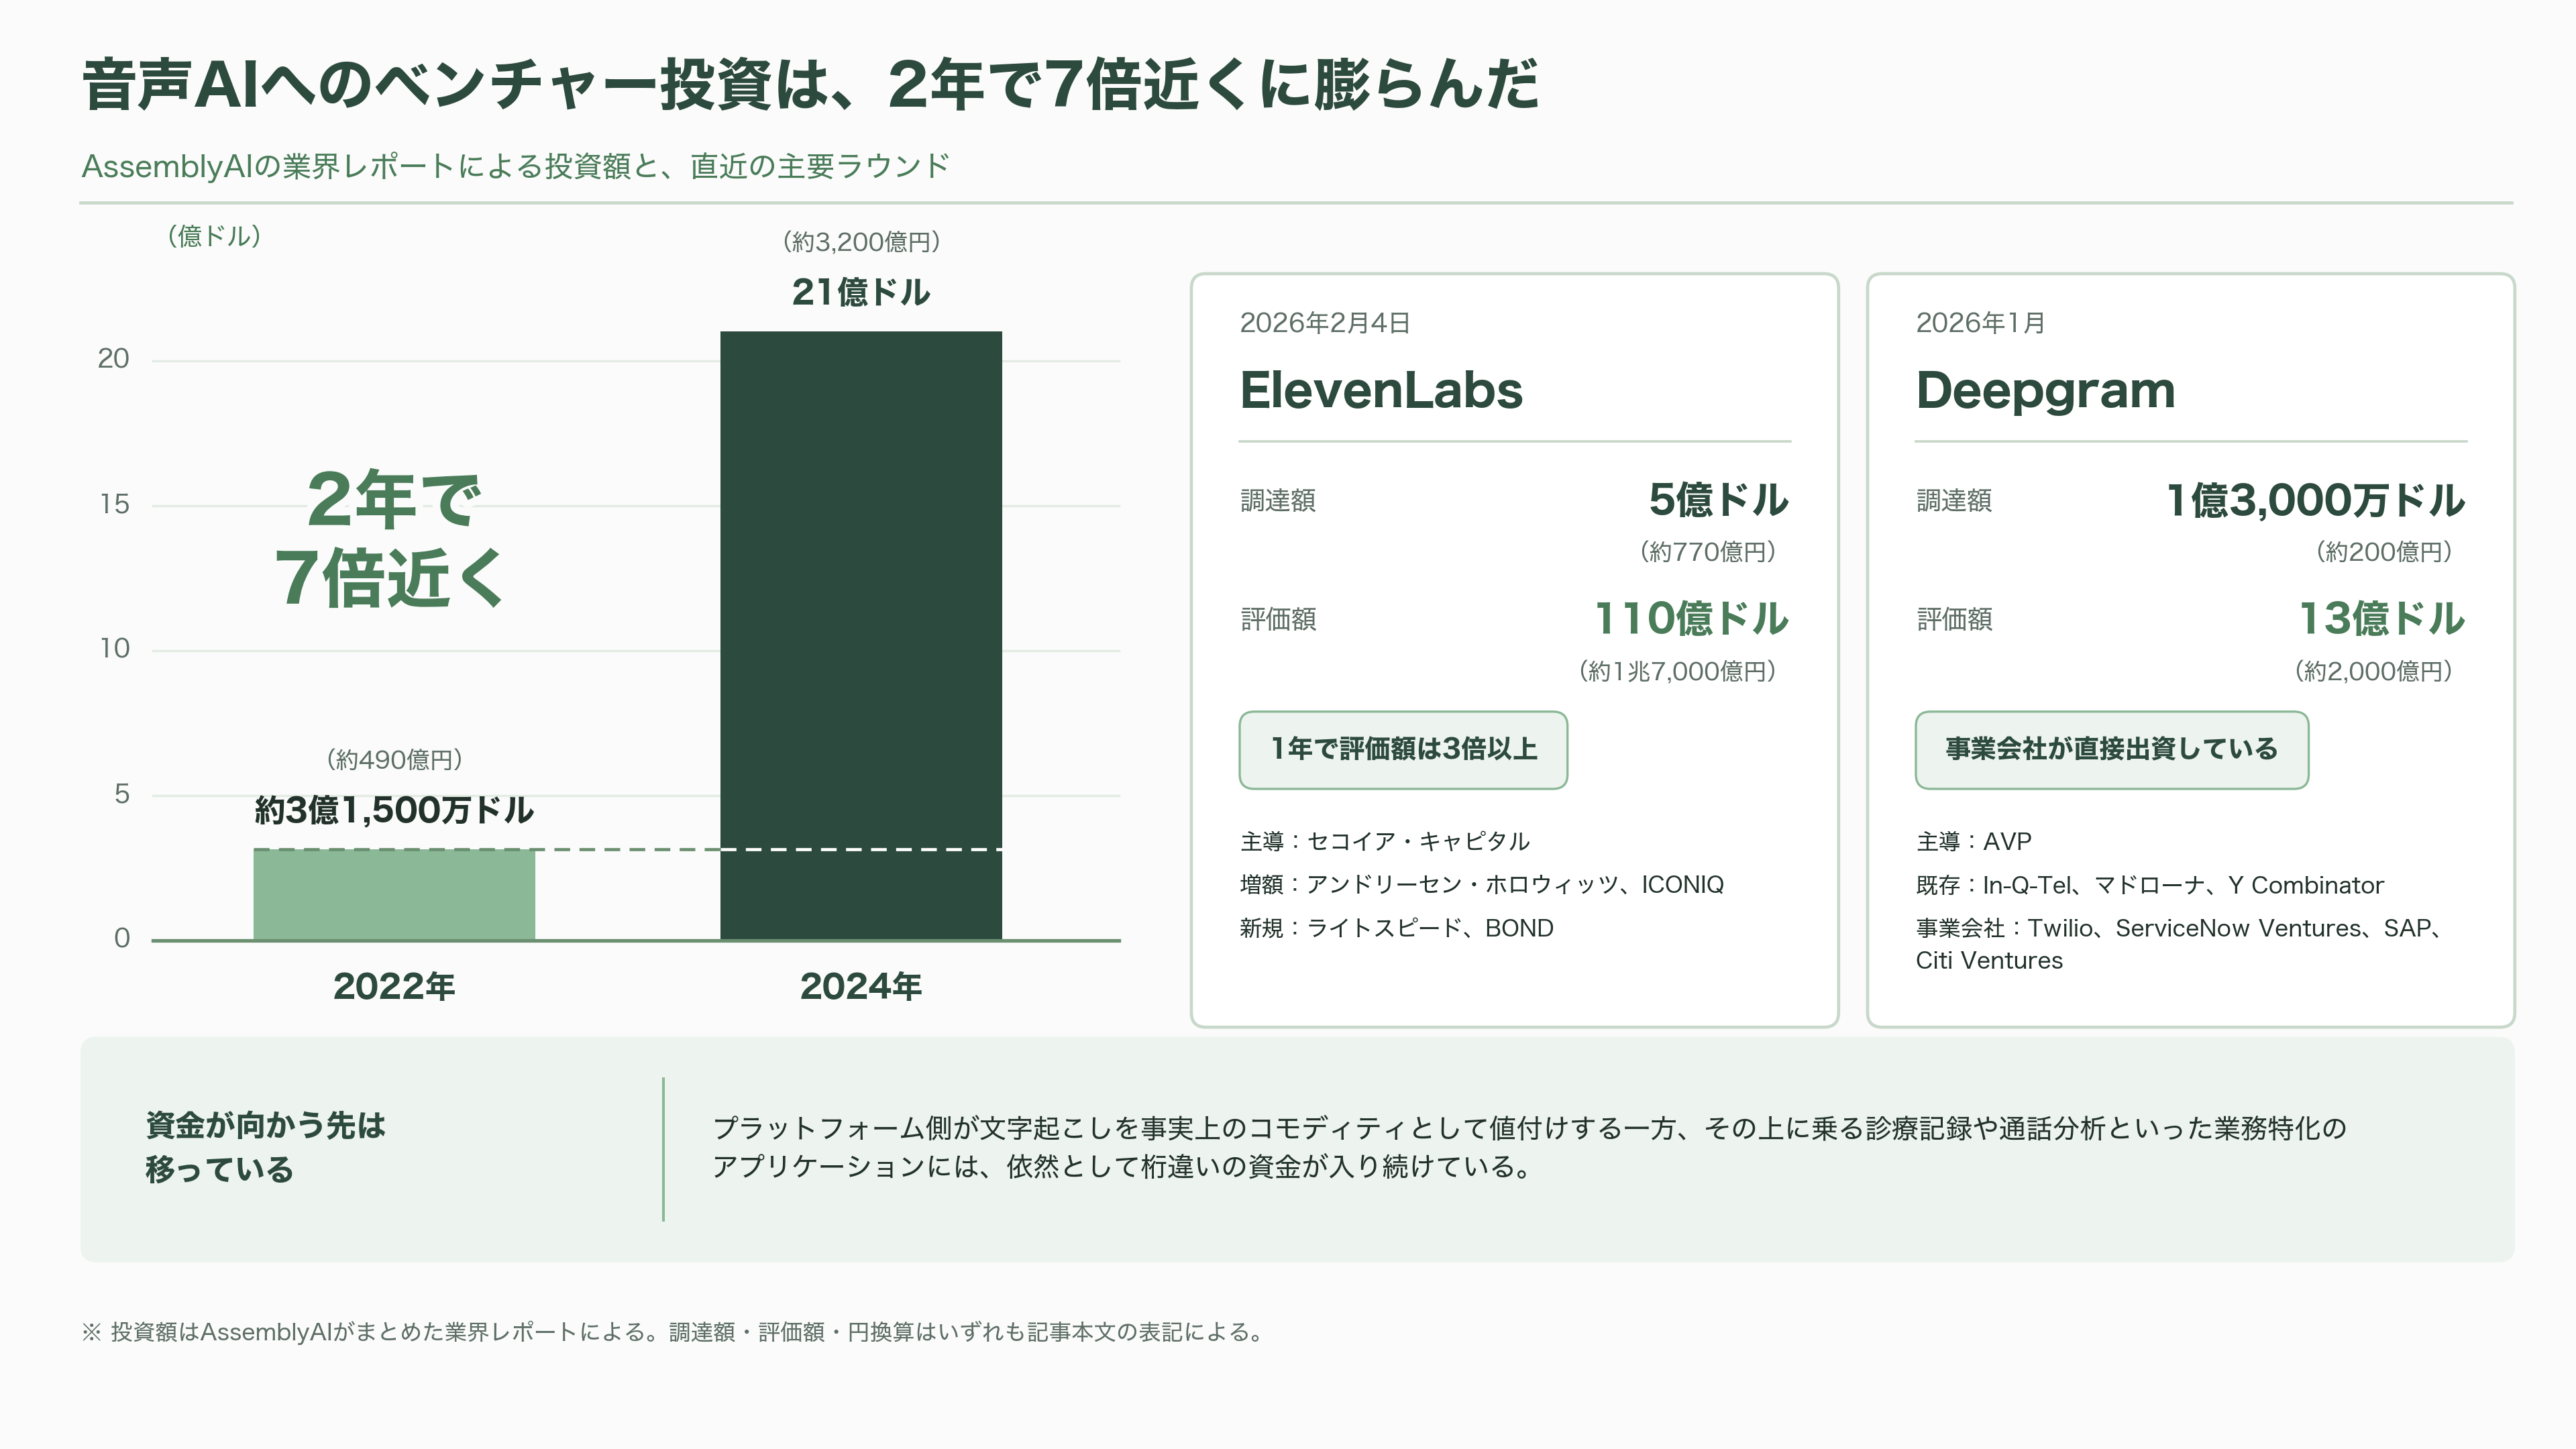
この価格帯で戦っているのは、しかし巨大テック企業だけではない。ElevenLabsは2026年2月4日にセコイア・キャピタル主導で5億ドル(約770億円)を調達し、評価額110億ドル(約1兆7,000億円)を付けた。1年で3倍以上である。アンドリーセン・ホロウィッツとICONIQが既存株主として増額し、ライトスピードとBONDが新規に入った。Deepgramは2026年1月にAVP主導で1億3,000万ドル(約200億円)を調達し、評価額13億ドル(約2,000億円)。この回にはIn-Q-Tel、マドローナ、Y Combinatorといった既存投資家に加えて、TwilioとServiceNow Ventures、SAP、Citi Venturesという事業会社側の資金が入っている。音声認識を自社製品の部品として押さえたい企業が直接出資しているという点が、この市場の性格をよく表している。
中国勢とオープンソースの存在も無視できない。Artificial Analysisの精度ランキングで首位に立つのはアリババ系のモデルで、同社は1月にQwen3-ASRを52言語対応でオープンソース公開した。英語圏ではNVIDIAのParakeetやCanaryが、手元のノートPCで動く実用的な選択肢として定着している。「クラウドAPIに月いくら払うか」ではなく「自分のマシンで無料で回すか」という選択肢が常に横にある市場なのだ。
なぜMicrosoftは自分で作るのか
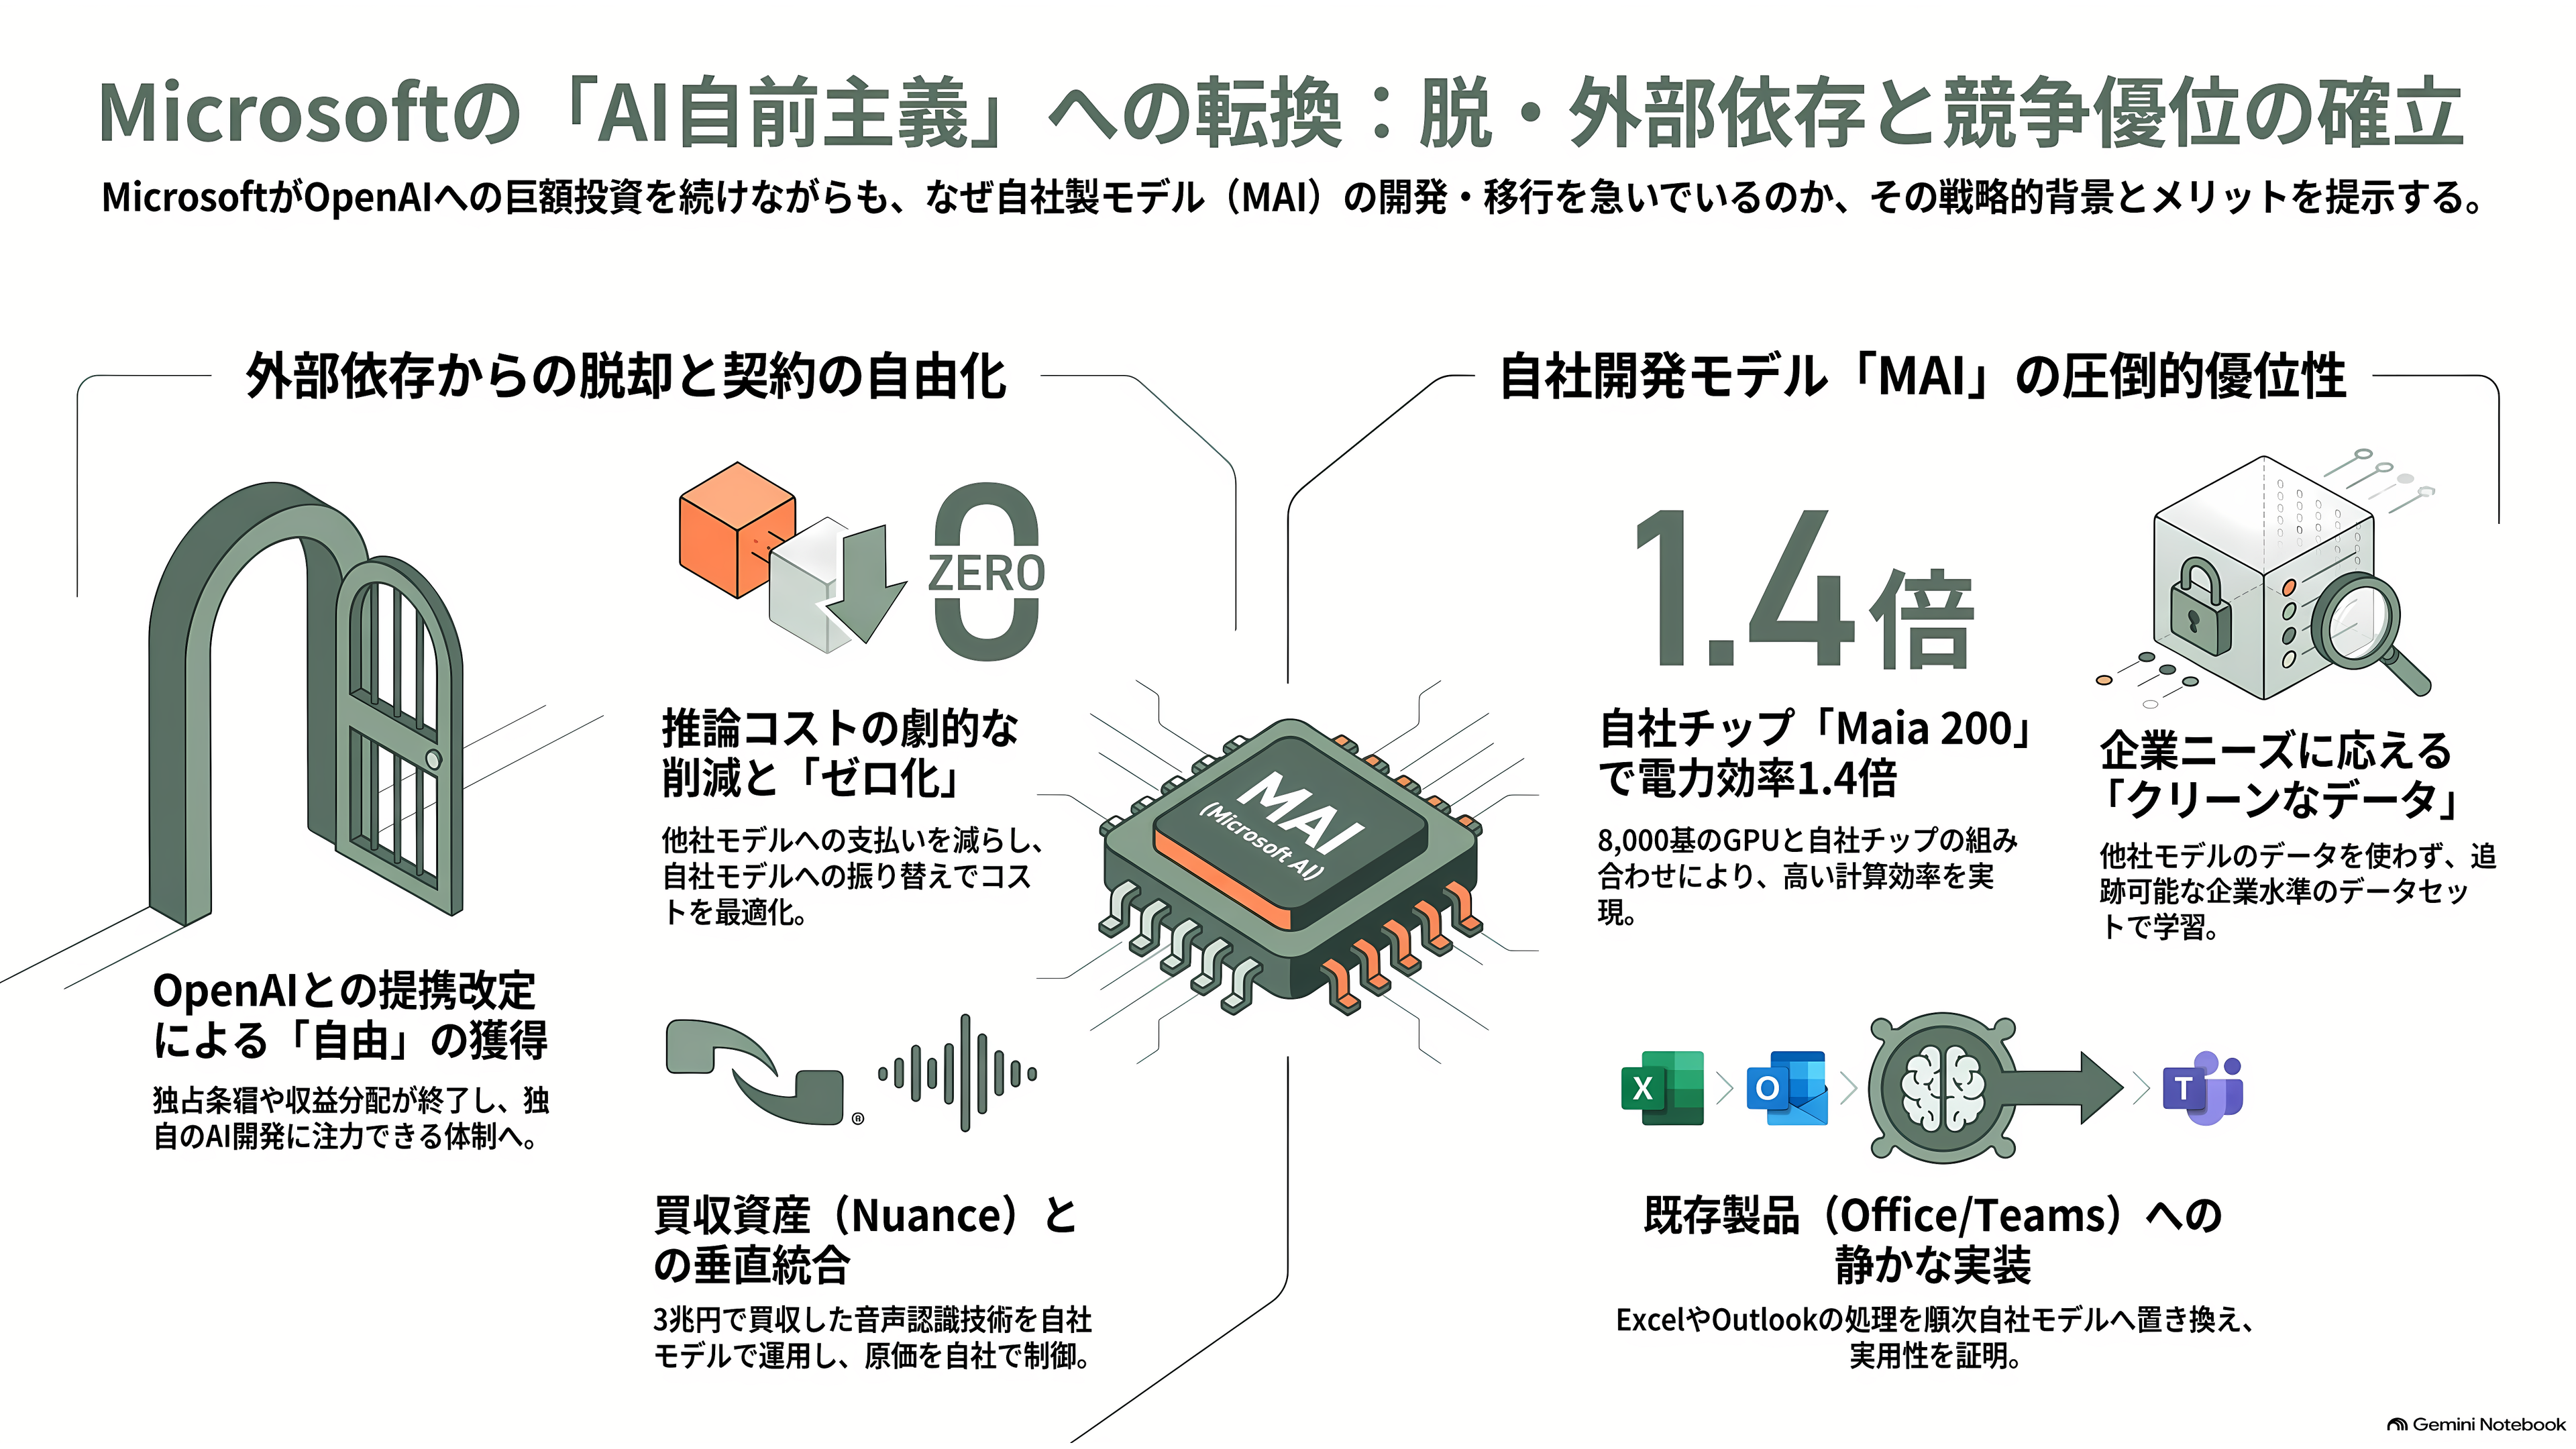
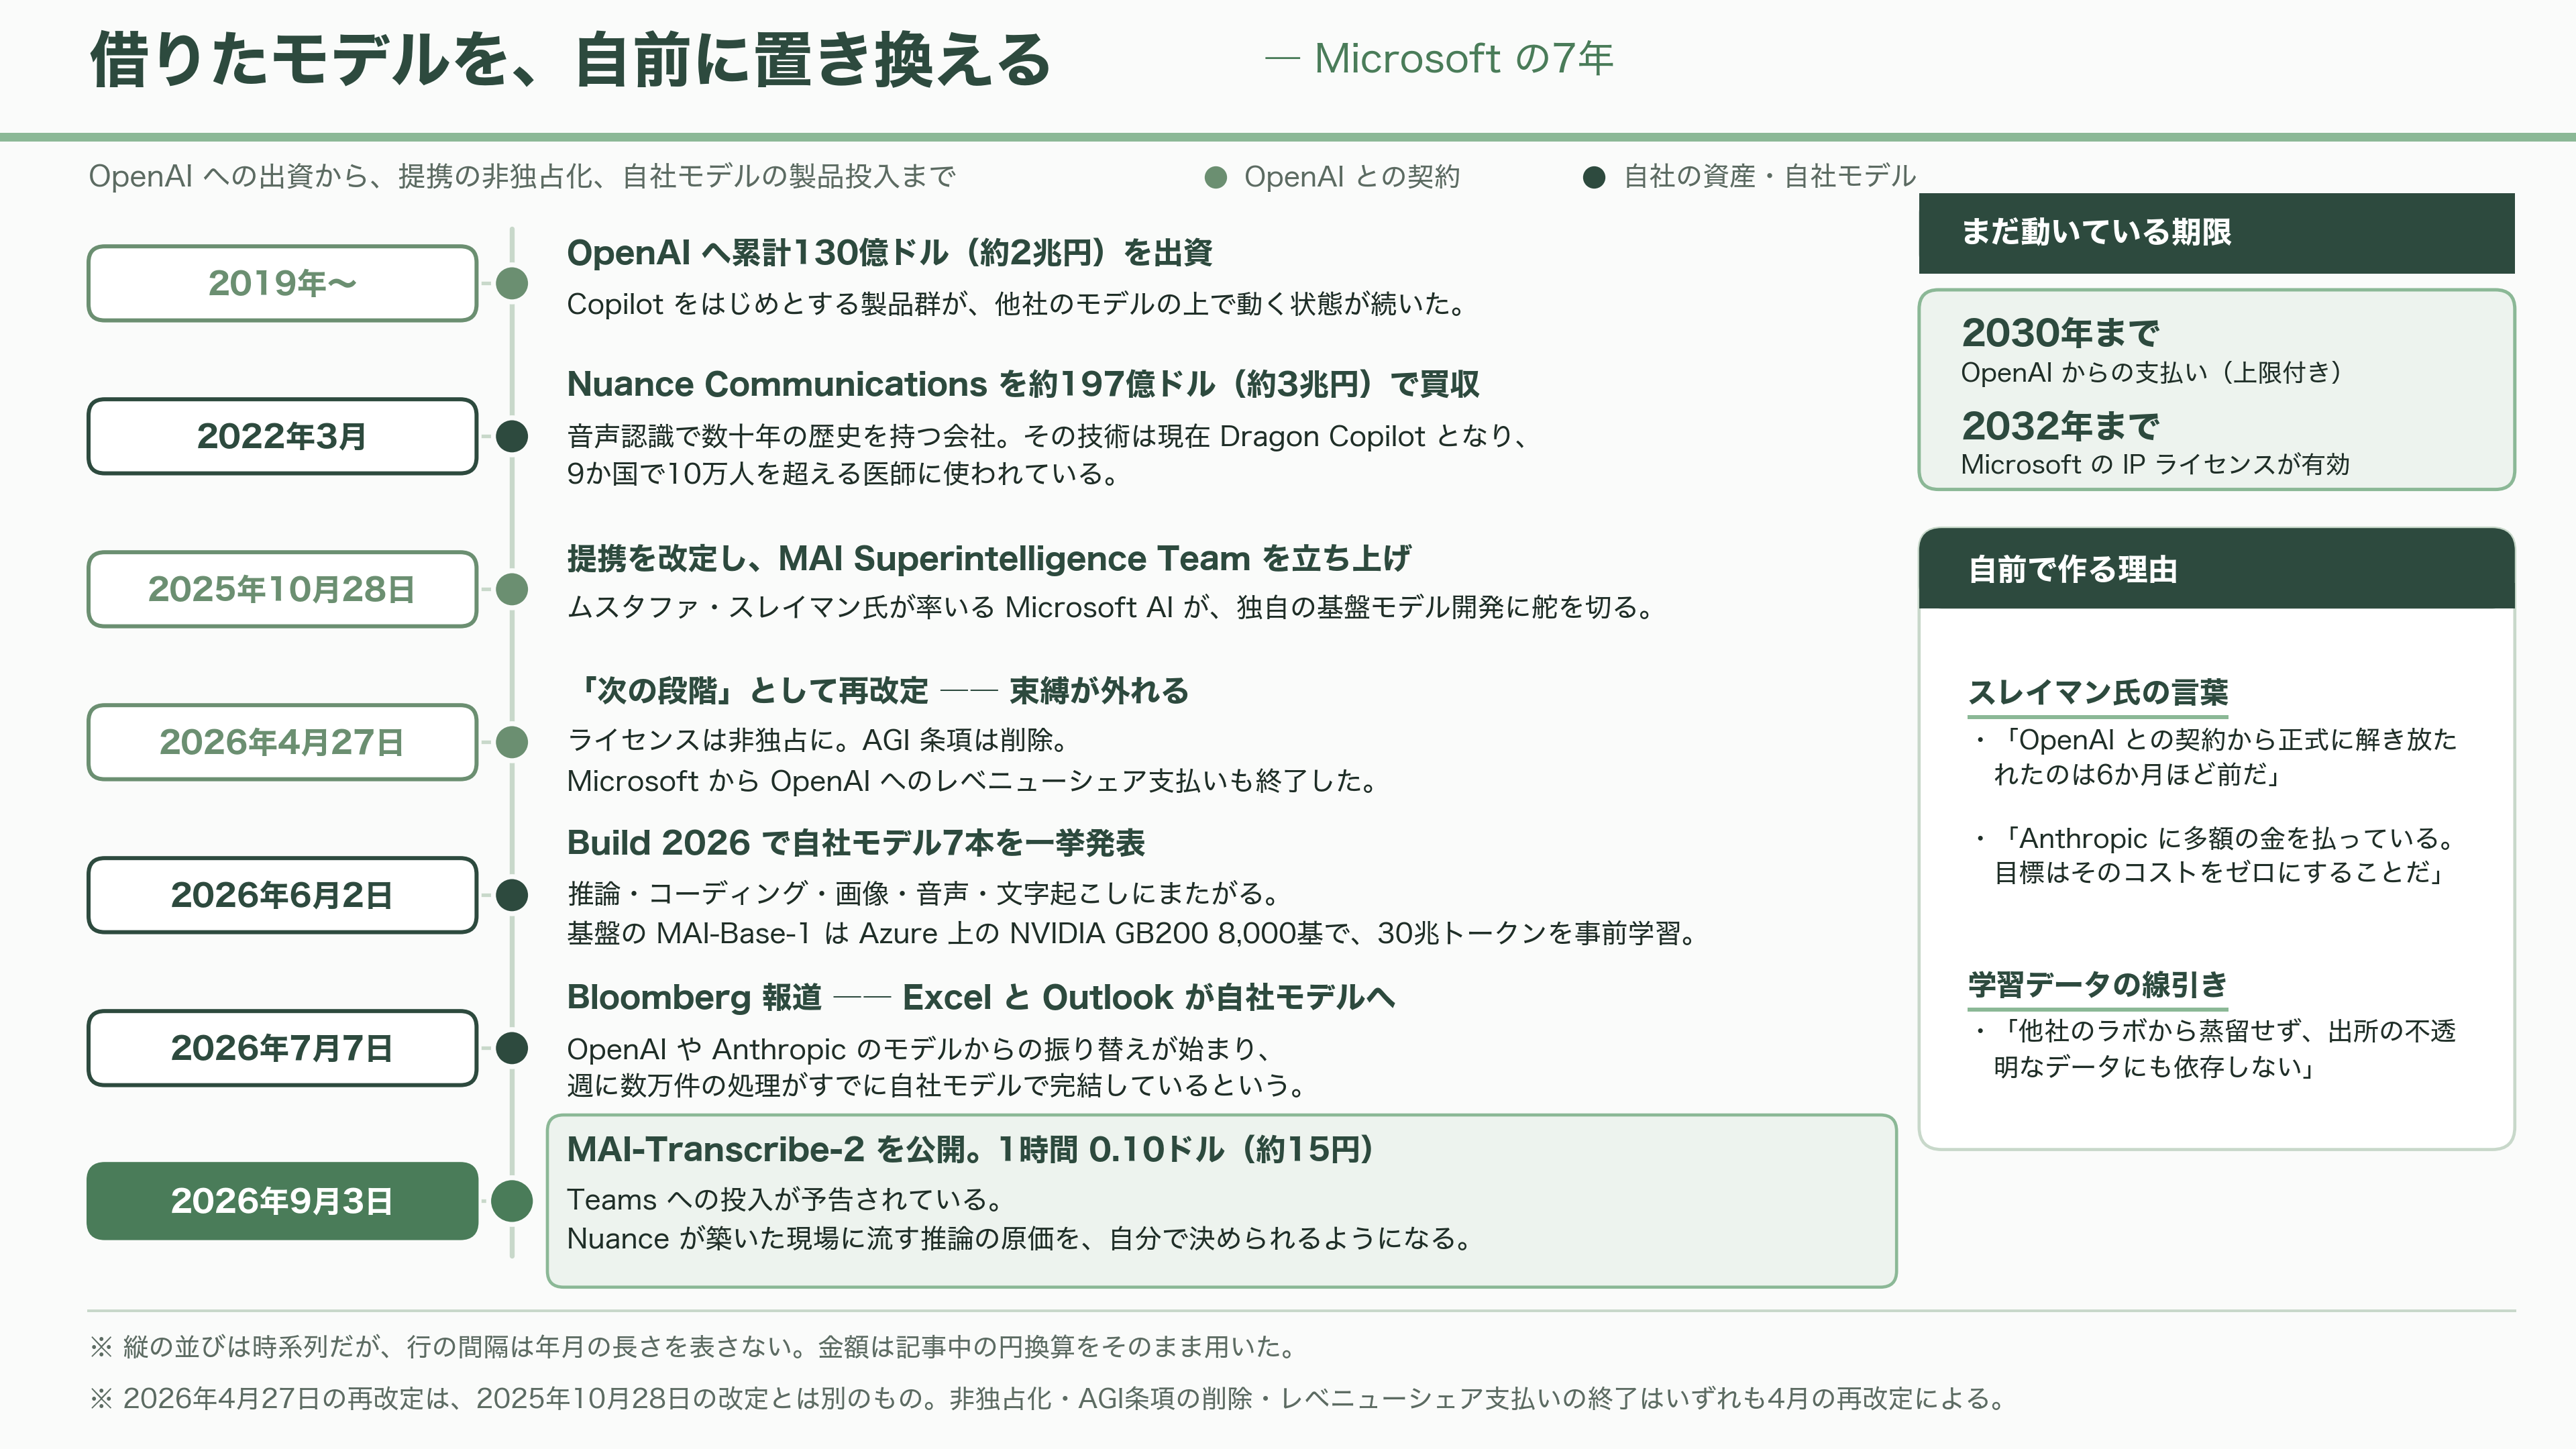
Microsoftは2019年以降、OpenAIに累計130億ドル(約2兆円)を投じてきた。その相手のモデルを使うのをやめて、自前で音声認識を作る理由は、まず契約の変化にある。
2025年10月28日に両社は提携を改定し、さらに2026年4月27日には「次の段階」と題した再改定を発表した。この改定でMicrosoftのライセンスは非独占となり、長く議論の的だったAGI条項は削除され、MicrosoftからOpenAIへのレベニューシェア支払いも終わった。OpenAI側からMicrosoftへの支払いは2030年まで上限付きで続き、MicrosoftのIPライセンスは2032年まで有効という形だ。
ムスタファ・スレイマン氏が率いるMicrosoft AIは、2025年秋の改定を受けてMAI Superintelligence Teamを立ち上げている。同氏は後に「OpenAIとの契約から正式に解き放たれたのは6か月ほど前だ」と振り返った。6月2日のBuild 2026では、推論・コーディング・画像・音声・文字起こしにまたがる7モデルを一挙に発表している。基盤となるMAI-Base-1は、Microsoftが自社運用するAzureクラスタ上で8,000基のNVIDIA GB200を使い、30兆トークンで事前学習したという。自社チップMaia 200との組み合わせでは、電力あたり性能で追加の1.4倍を得たとしている。
学習データについて、Microsoft AIは明確な線を引いている。「我々は他社のラボから蒸留しないし、出所の不透明なデータにも依存しない。我々のデータセットは、クリーンで、追跡可能で、企業向けの水準にある」。競合モデルの出力を教師データに使わないという宣言で、企業顧客が気にするデータ由来のリスクを断つ狙いがある。
そしてコストだ。Bloombergは2026年7月7日、MicrosoftがExcelとOutlookのAI処理の一部を、OpenAIやAnthropicのモデルから自社のMAIモデルへ振り替え始めたと報じた。週に数万件の処理がすでに自社モデルで完結しているという。スレイマン氏の言い方は率直だった。「我々はAnthropicに多額の金を払っている。だから目標は、そのコストを減らし、最終的にゼロにすることだ」。
文字起こしについては、Teamsへの投入が予告されている。ここで効いてくるのが、Microsoftが持つもう一つの資産だ。同社は2022年3月にNuance Communicationsを約197億ドル(約3兆円)で買収している。音声認識で数十年の歴史を持つ会社で、その技術は現在Dragon Copilotという臨床向け製品になり、9か国で10万人を超える医師に使われている。診察室の会話を聞いて構造化されたカルテを生成する製品だ。自社の基盤モデルを持てば、この巨大な現場に流す推論の原価を自分で決められる。
音声認識という技術単体で見れば地味な発表に見えるが、Microsoftにとっては「借りたモデルで動いている製品群を、自前のモデルに置き換える」という長期の作業の一部である。VentureBeatはこのパターンを、明確に定義されたモダリティを狙い、推論コストを徹底的に削り、フロンティアのラボより安く値付けし、Foundryで配り、自社製品の中身を静かに入れ替える、と要約した。
この安さが変える現場
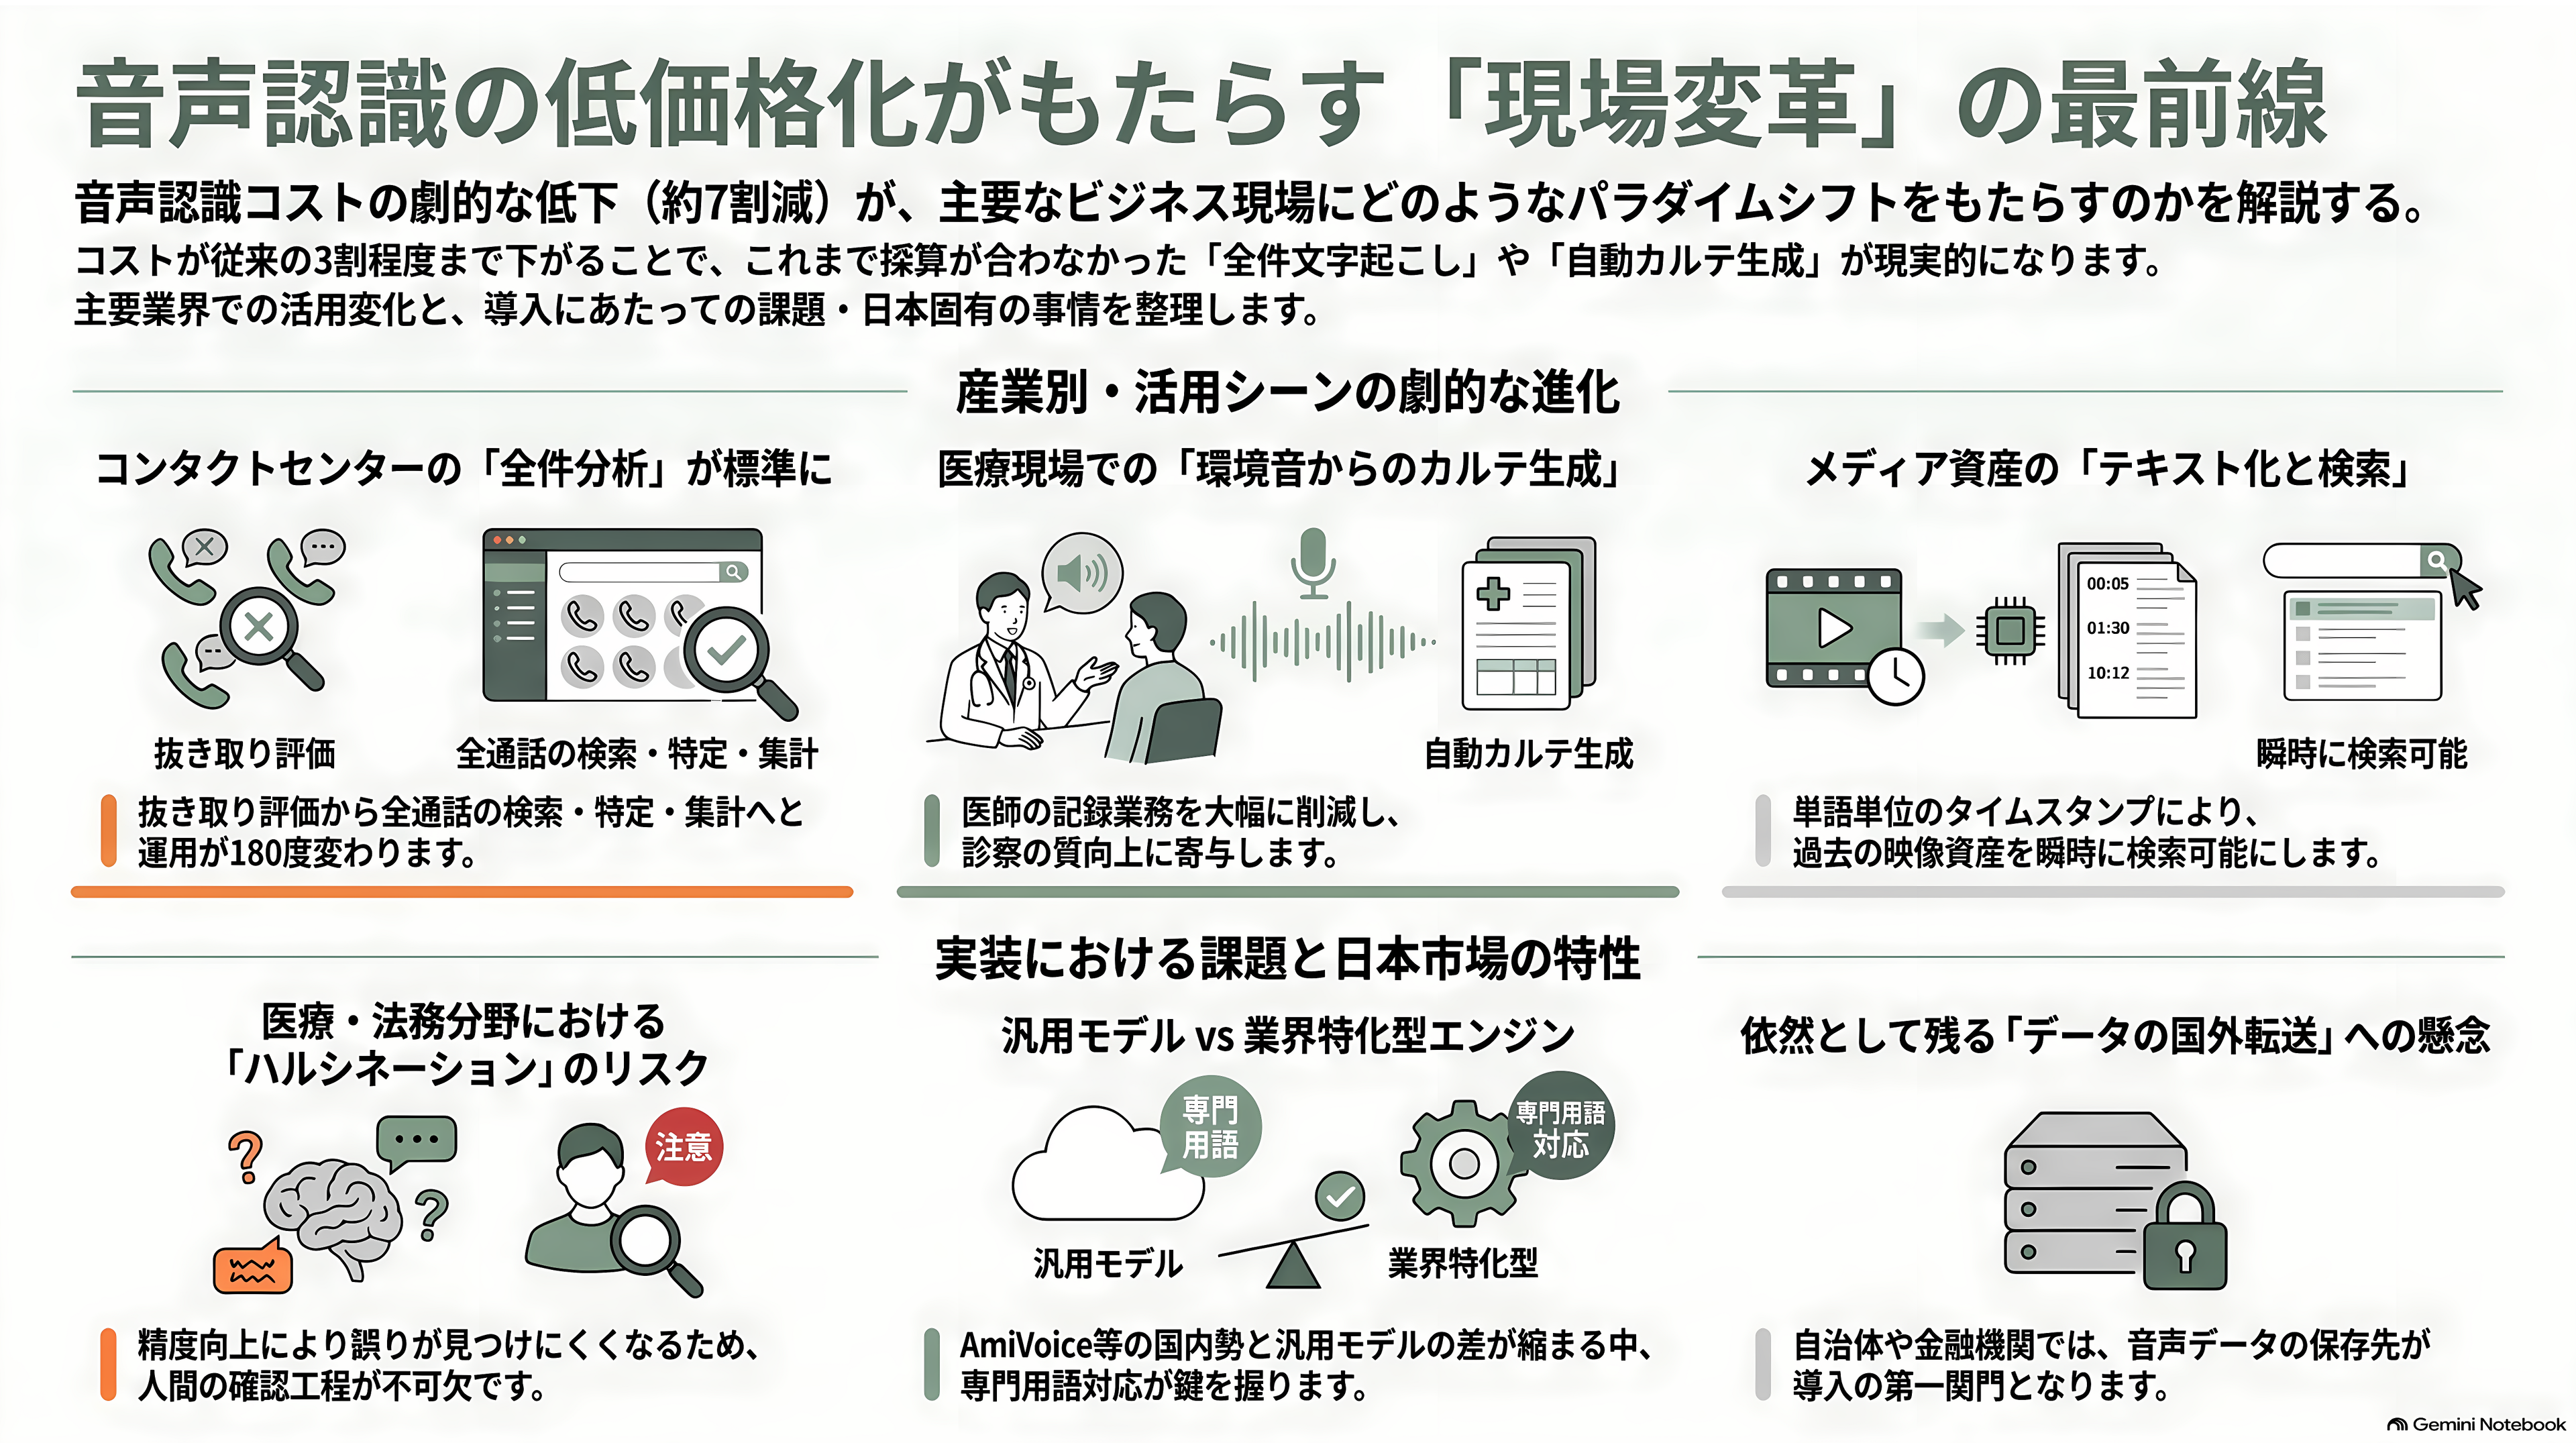
料金が7割落ちると、これまで採算に合わなかった使い方が成立する。
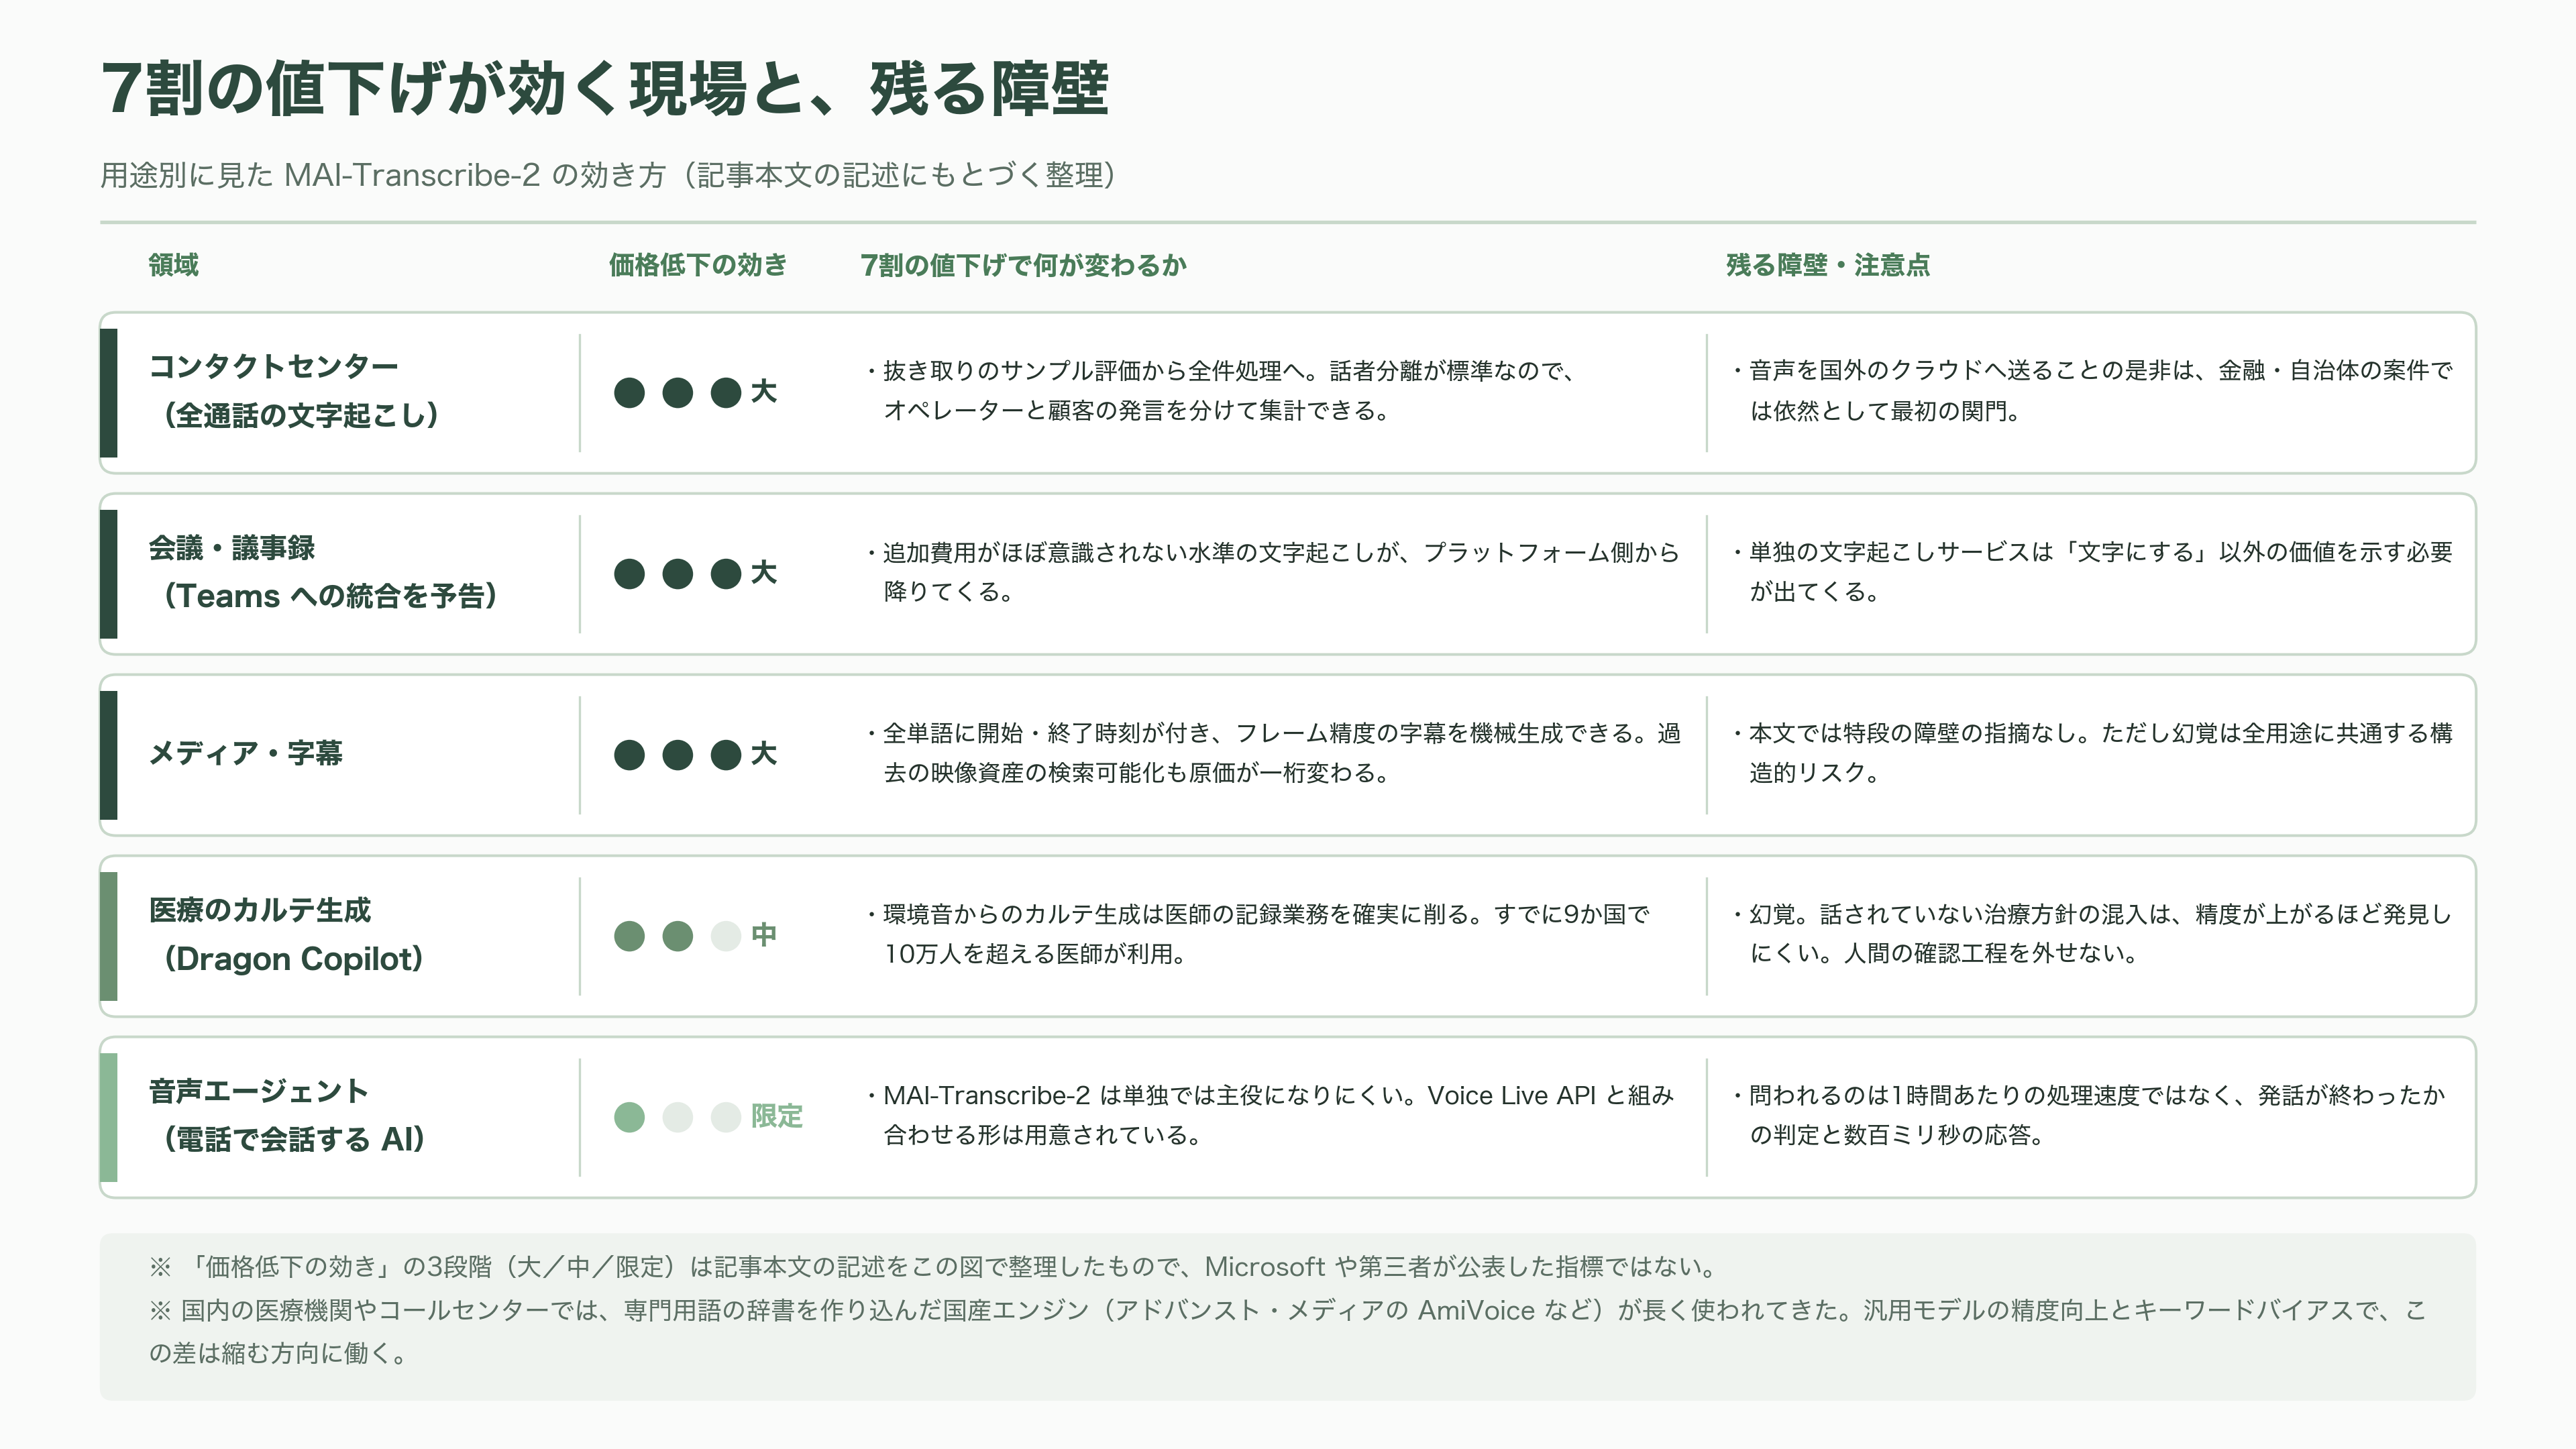
もっとも直接的なのはコンタクトセンターだ。従来、全通話の文字起こしはコストが見合わず、抜き取りでサンプル評価するのが普通だった。それが全件を回せる価格になると、「クレームにつながった通話を後から検索する」「特定の説明が漏れていた会話を洗い出す」といった、全数を前提とした運用が現実味を帯びる。話者分離が標準で付いているので、オペレーターの発言と顧客の発言を分けたうえで集計できる。
会議と議事録は、Teamsへの統合が予告されている領域だ。日本企業では議事録作成の負担が慢性的な課題として残っていて、すでに専用サービスが数多く使われている。ここに、追加費用がほぼ意識されない水準の文字起こしがプラットフォーム側から降りてくると、単独の文字起こしサービスは「文字にする」以外の価値を示す必要が出てくる。
メディアと字幕の分野では、単語単位のタイムスタンプが効く。全単語に開始時刻と終了時刻が付くということは、書き起こしの任意の語をクリックすればその瞬間の音声に飛べるということであり、フレーム精度の字幕を機械的に生成できるということでもある。過去に貯め込んだ映像資産をまとめてテキスト化して検索可能にする、という作業の原価も一桁変わる。
医療は最も期待が大きく、同時に最も慎重さが要る。Dragon Copilotのような環境音からのカルテ生成は、医師の記録業務を削る効果がはっきり出ている領域だ。一方で前述の幻覚の問題があり、記録に「話されていない治療方針」が紛れ込むリスクは、精度が上がるほど発見しにくくなる。医療や法務のように誤りが直接損害になる分野では、人間の確認工程を外せない状態が当分続く。
音声エージェント、つまり電話で人間と会話するAIについては、MAI-Transcribe-2は単独では主役になりにくい。この用途で問われるのは1時間の処理速度ではなく、話し終わってから文字が確定するまでの数百ミリ秒であり、相手が話し終えたかどうかの判定精度だからだ。MicrosoftのVoice Live APIと組み合わせる形は用意されているが、専用に設計されたMetaやDeepgramの製品と正面から比べられる段階には来ていない。
日本での受け止め方には、もう一段の事情がある。国内の医療機関やコールセンターでは、専門用語の辞書を作り込んだ国産エンジンが長く使われてきた。上場企業のアドバンスト・メディアが手がけるAmiVoiceがその代表格で、業種別の専用モデルを揃えることで汎用モデルとの差を作ってきた。汎用モデルの精度が上がりキーワードバイアスで用語を寄せられるようになると、この差は縮む方向に働く。一方で、音声を国外のクラウドに送ることの是非は、医療・金融・自治体の案件では依然として最初の関門であり続ける。
次に何が動くか
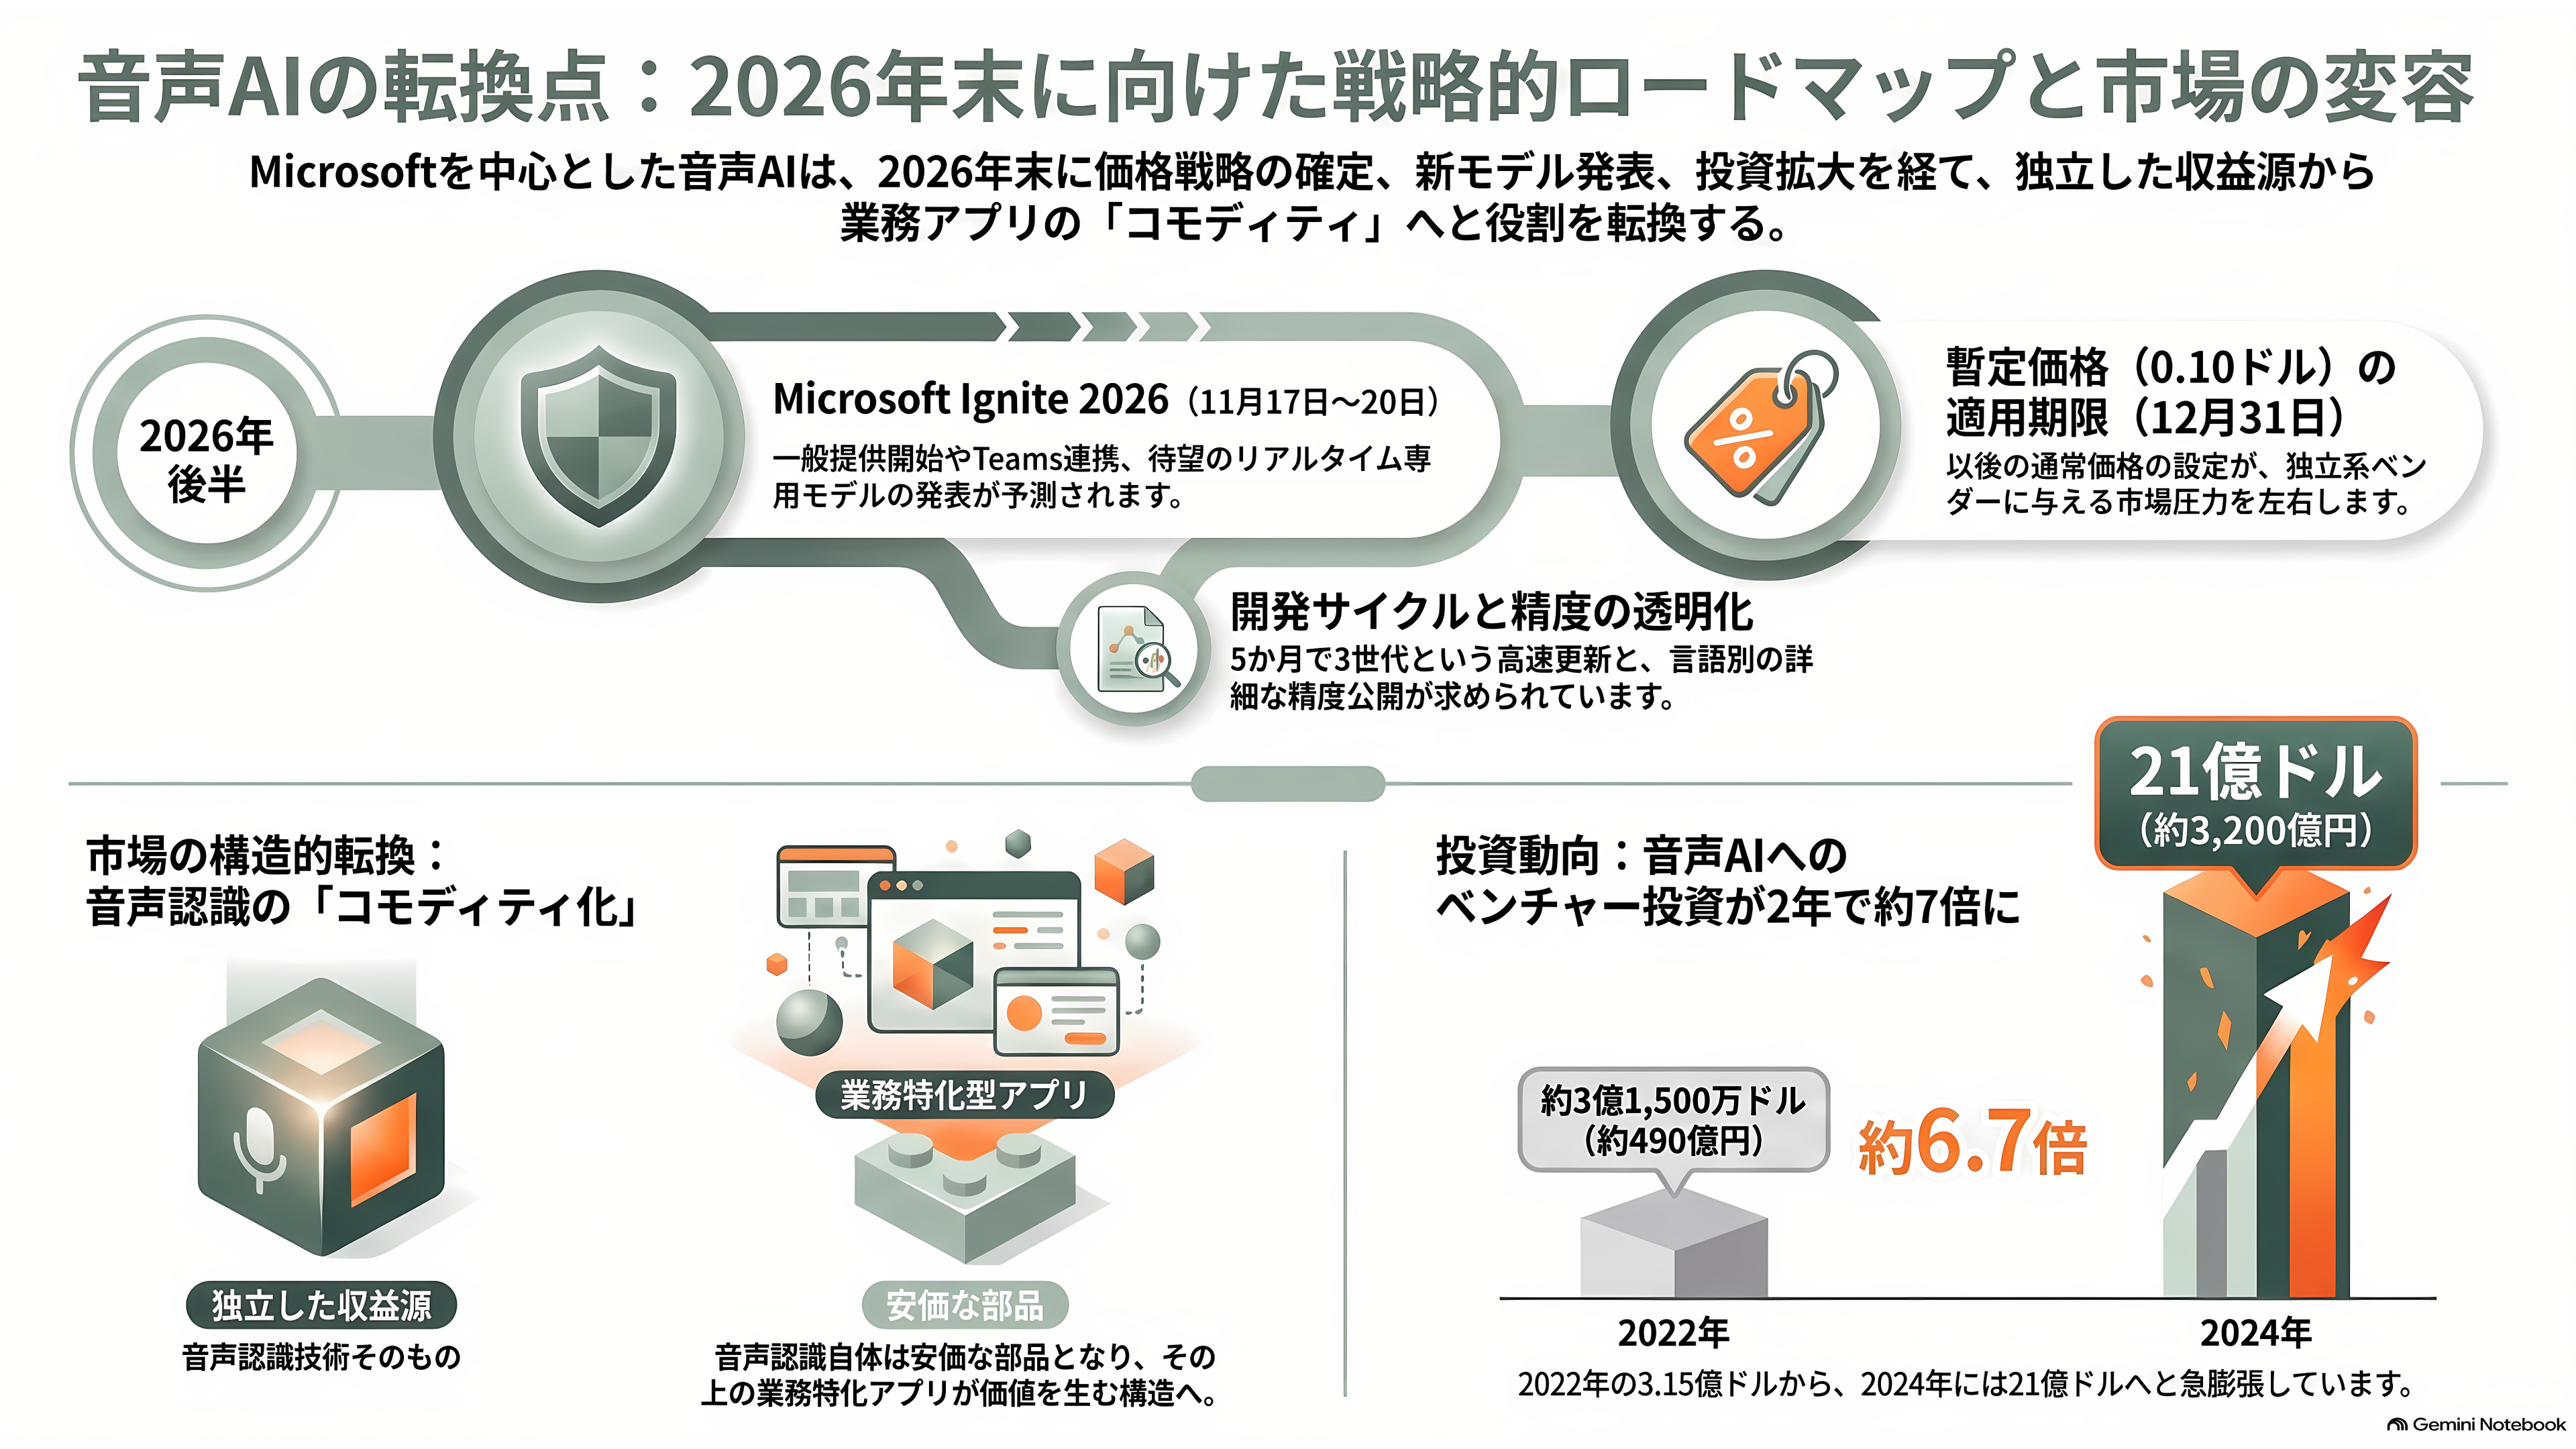
最初の節目は2026年12月31日だ。0.10ドルという価格の期限であり、その後の通常価格がいくらになるかが、この発表の意味を決める。Microsoftは通常価格をまだ示していない。Hacker Newsで開発者が真っ先に投げた問いがこれだったのは、業界がこの数字を待っているからである。前世代の0.36ドルに戻るのか、値下げを恒久化するのかで、独立系ベンダーが受ける圧力の大きさは全く変わる。
次が11月17日から20日にサンフランシスコのモスコーニ・センターで開かれるMicrosoft Ignite 2026である。同社の企業向け最大のイベントで、一般提供への移行、Teamsへの組み込み、そしてストリーミング版の有無が示されるとすれば、時期としてはここが最も自然だ。
ストリーミングは、そのまま最大の空白でもある。Googleはライブ版を持ち、OpenAIも持ち、Metaはリアルタイムを主戦場に据えて首位に立った。Microsoftには従来からのAzure Speechのリアルタイム認識とVoice Liveがあるものの、MAIの名を冠したリアルタイム専用モデルは存在しない。音声認識の需要が録音の後処理から会話中の処理へ移りつつあることを踏まえると、次の一手がここに来ない理由は考えにくい。
開示の面で待たれているのは、言語別の精度内訳と話者分離の誤り率だ。60言語平均という提示の仕方は、日本語で何%なのかを知りたい導入担当者には答えになっていない。Metaが話者分離の誤り率を数値で出したことで、この項目を出さないこと自体が比較上の弱点になりつつある。
リリースの間隔そのものも情報になる。4月に初代で25言語、6月に1.5世代で43言語、9月に2世代で60言語。3世代を5か月で出し、そのたびに対応言語を大幅に増やしてきた。同じペースなら、次の世代は年内から年明けにかけて来る計算になる。
そしてこの競争の下地には、資金の流れがある。AssemblyAIがまとめた業界レポートによれば、音声AIへのベンチャー投資は2022年の約3億1,500万ドル(約490億円)から2024年には21億ドル(約3,200億円)へ、2年で7倍近くに膨らんだ。プラットフォーム側が文字起こしを事実上のコモディティとして値付けする一方で、その上に乗る診療記録や通話分析といった業務特化のアプリケーションには、依然として桁違いの資金が入り続けている。音声認識そのものが利益を生む場所から、何かを動かすための安価な部品へと移りつつある——2026年9月の一連の発表が示しているのは、その転換点である。